论文阅读:OpenVLA: An Open-Source Vision-Language-Action Model
引:Moo Jin Kim、Karl Pertsch、Siddharth Karamcheti 等人在这篇文章中提出 OpenVLA,将已有的视觉语言模型微调为机器人控制策略。模型接收一张图像和一条指令,将七维机器人动作转换为离散 token,再使用语言模型的 next-token prediction 方式训练。作者在约 97 万条机器人轨迹上训练模型,并开放权重、训练与部署代码,进一步研究新任务微调、LoRA 和量化推理。
背景
假设我们让机器人“把茄子放进碗里”。这要求机器人看出哪个物体是茄子、碗在哪里,还要根据当前夹爪的位置,决定下一步向哪里移动、怎样调整姿态,以及什么时候闭合夹爪。
视觉语言模型(Vision-Language Model,VLM)已经从大量图像和文本中学习了物体、语义和一定的空间关系。问题是, 理解图像中的任务,并不会自动得到能够执行的机器人动作。一个模型即使能准确描述“茄子在碗的左边”,也还没有学会输出机械臂所需的控制量。
VLA(Vision-Language-Action Model)尝试把这一步接起来:在预训练 VLM 的基础上,用机器人示范训练模型,使它根据图像和语言直接预测动作。这里的训练属于模仿学习,监督来自示范中的实际动作,不需要为每次动作另外设计奖励函数。
在 OpenVLA 之前,RT-2 等工作已经验证了这种路线。但这些模型的权重、训练细节或适配方法并不充分开放,研究者很难把它们迁移到自己的机器人上。OpenVLA 要解决的问题因此包括两部分:一是训练一个有较好泛化能力的通用机器人策略;二是让这个策略能够被研究者实际部署和微调。
方法
视觉语言模型
OpenVLA 基于已经完成视觉语言训练的 Prismatic-7B,整体由视觉编码器、projector 和语言模型三部分组成:
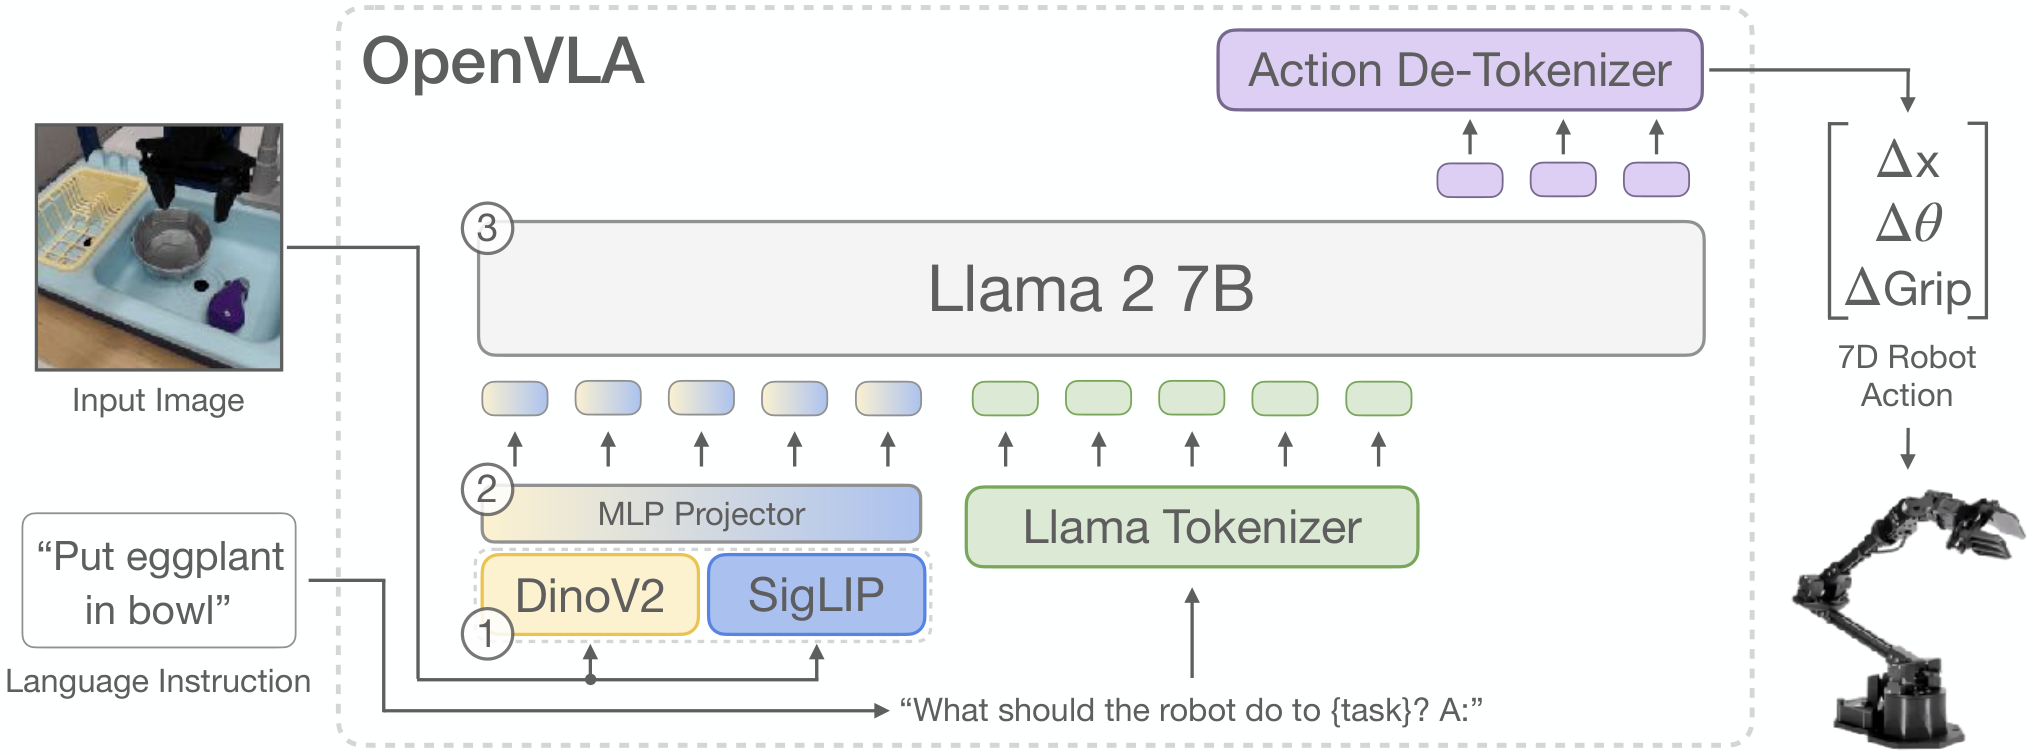
图来自原论文 Fig. 2。输入是当前图像和语言指令,输出经动作解码后交给机器人控制器。
对于图像,作者同时使用 DINOv2 和 SigLIP。同一张图像分别经过两个视觉编码器,然后将对应 patch 的特征沿通道维拼接。SigLIP 的图文预训练提供语义信息,加入 DINOv2 的特征则有助于补充空间信息;它们并不是分别只负责“语义”或“位置”,而是共同为后续预测提供视觉表示。
这里的拼接发生在每个 patch 的特征向量上。比如,同一个 patch 原来分别得到两组特征,现在把它们接成一个更长的向量,而不是把两套 patch 序列首尾相接。随后,两层 MLP 构成的 projector 将这些视觉特征映射到语言模型所需的 embedding 空间。
语言指令则由 Llama tokenizer 转换为文本 token,再取得相应的 embedding。视觉 embedding 和文本 embedding 一起送入 Llama 2 7B 主干,模型根据二者预测输出序列。
需要区分两种 token:图像 patch 在这里对应连续的特征向量;后面生成的动作 token 则是词表中的离散编号。图像并没有先经过一个 VQ 码本,变成与动作相同的离散符号。
Prismatic 本身建立在预训练的 SigLIP、DINOv2 和 Llama 2 上,再通过约 100 万条图文及纯文本样本进行视觉语言训练。OpenVLA 接着在这个模型上学习机器人动作,因此并不是从零开始训练视觉和语言能力。
训练
我们先明确模型要预测什么。在本文的单臂控制设定中,一个时间步的动作包含七个维度:
- 三个末端位置变化量;
- 三个末端姿态变化量;
- 一个夹爪控制量。
前六个量描述机械臂末端应该怎样移动和转动,最后一个量控制夹爪。这里的“七维动作”并不意味着直接预测七个关节角度,底层控制器还需要把末端动作转换为机器人能够执行的控制指令。
语言模型原本预测的是离散 token,机器人动作却是连续数值。作者因此沿用 RT-2 的思路, 将每个动作维度分别离散为 256 类,用 token 表示其所处的区间。
具体地,对每个维度,先统计训练数据中动作的第 1 和第 99 百分位数,再在这个范围内均匀划分。为什么不用最小值和最大值?如果少量异常动作特别大,整个离散范围就会被拉宽,常见动作只能挤在少数几个区间中。使用分位数能够减轻这种影响,让有限的离散类别更多地覆盖常见动作范围。
例如,假设某个平移维度的有效范围是 −2 cm 到 2 cm,示范要求沿这个方向移动约 1 cm。量化后,我们用覆盖这个数值的区间编号表示该动作分量;其他六个维度做同样的处理。于是,原来的七维连续动作变成七个离散编号,每个编号再对应词表中的一个动作 token。它不是把小数写成字符串,再让模型逐个生成数字和小数点。
Llama tokenizer 只预留了 100 个特殊 token,不足以容纳 256 种动作符号。因此,作者复用了词表末尾使用频率最低的 256 个 token,将它们作为动作 token。这里复用的是模型的输出词表,动作仍然需要通过专门的解码过程才能恢复为数值。
动作变成 token 后,就可以使用标准的 next-token 交叉熵训练。训练样本的上下文包含图像、语言和已经出现的真实动作 token,模型学习预测下一个动作 token, 损失只计算动作输出位置。
比如,在“把茄子放进碗里”的示范中,相机图像和指令作为条件,示范动作提供七个目标 token。训练时,第一个动作 token 根据图像与指令预测;第二个还可以看到真实的第一个动作 token;后面依次进行。这就是 teacher forcing,配合 causal mask,模型不能提前看到尚未预测的位置。
这里的七个 token 表示 同一个控制时间步的七个维度,并不是未来七个时间步。训练时虽然可以一次计算各个位置的损失,但推理时尚无真实动作可供输入,仍需要把已经生成的 token 逐个送回模型,才能继续预测下一个。
推理
推理时,动作生成与执行可以整理为:
- 获取机器人当前的一张第三人称 RGB 图像,并输入任务指令;
- 通过视觉编码器和 projector 得到图像 embedding,与文本一起送入语言模型;
- 自回归生成当前动作的七个 token;
- 将 token 转回离散区间,并用区间中心恢复归一化的动作数值;
- 根据目标数据集的动作统计量反归一化,得到控制器所需的动作;
- 执行动作,获取新的图像,再预测下一步。
反归一化不能省略。相同的归一化数值,在不同机器人或数据集的动作尺度下可能对应不同的实际运动量。官方推理接口因此需要选择相应的数据集统计量,不能直接把 token 编号或者归一化后的数值当作真实控制量使用。
这个过程中,模型每次只预测一个控制步;机器人执行之后,再通过新的观测修正后续动作,形成闭环。原始 OpenVLA 没有一次输出未来一整段 action chunk,也没有使用扩散过程生成动作。
数据
OpenVLA 的机器人训练数据来自 Open X-Embodiment(OpenX)。在论文写作时,完整 OpenX 汇集了 70 多个数据集、超过 200 万条机器人轨迹;OpenVLA 从中筛选并组合出约 97 万条轨迹。这里的数量是完整的示范轨迹,不是 97 万张图像或 97 万个动作。
不同机器人的传感器和控制方式并不一致。为了得到可共同训练的输入输出空间,作者筛选出至少包含一个第三人称相机、采用单臂末端控制的数据集。这样,不同机器人仍然可以共用“图像与语言输入、末端动作输出”的形式。
数据量大也不意味着可以简单混在一起等概率采样。有些数据集轨迹很多,但任务和场景相对重复,可能淹没较小却更加多样的数据集。作者参考 Octo 的混合权重,降低部分低多样性数据的权重,提高任务和场景更丰富的数据的权重。
作者还尝试加入后来新增的 DROID 数据,最初给予 10% 的混合权重。但训练中 DROID 的动作 token 准确率持续较低,说明当时的模型与采样配置尚未充分拟合这部分数据。因此,最终训练的后三分之一移除了 DROID。
设计选择
在完整 OpenX 训练之前,作者先在较小的 BridgeData V2 上迭代模型。主要选择包括:
- VLM 主干:比较 IDEFICS-1、LLaVA 和 Prismatic。不同主干在多物体场景中的语言指令理解能力存在明显差异,最终选择效果更好、代码也便于扩展的 Prismatic。
- 图像分辨率:比较 和 。在这些实验中,较高分辨率没有带来明显的机器人性能收益,却需要约三倍训练时间,因此最终使用 。
- 视觉编码器:在机器人动作训练中更新视觉编码器。冻结视觉特征会损害控制表现,作者推测,机器人操作需要比一般图文任务更加精细的空间信息。
- 训练轮数:最终完成 27 个 epoch。机器人表现随着训练继续改善,直到训练动作 token 准确率超过 95%。这个 95% 是 token 预测准确率,不能当作任务成功率。
- 学习率:最终使用固定的 ,没有观察到 learning rate warmup 的收益。
训练与部署
最终模型使用 64 张 A100 训练 14 天,约合 21,500 A100 GPU 小时,batch size 为 2048。
部署时,论文报告完整模型以 bfloat16 加载约需 15 GB 显存,在单张 RTX 4090 上约为 6 Hz,尚未使用编译或其他推理加速。这里的频率是每秒生成完整控制动作的次数。对于低频桌面操作,这样的速度可以使用;对于需要几十 Hz 控制的双臂或灵巧操作,逐 token 解码就会成为限制。
作者也提供远程推理服务,使机器人能够向外部 GPU 服务器发送观测并接收动作,不必在机器人本地配置能够运行整个模型的显卡。
代码
OpenVLA 同时开放模型权重,以及机器人训练、微调和部署代码。代码基于 PyTorch,支持混合精度、FlashAttention 和 FSDP,既能在多机 GPU 上训练,也支持通过 Hugging Face 接口加载,以及后面的 LoRA 微调和量化推理。
这部分开放的是建立在预训练组件之上的 OpenVLA 工作流程。SigLIP、DINOv2 和 Llama 2 提供了可用权重,但它们各自的全部预训练数据和训练代码并没有随 OpenVLA 一起开放。
实验
直接评估
作者首先评估,预训练模型不经过目标任务微调,能否在 WidowX 和 Google Robot 上完成操作。这两类机器人及相应数据域已经包含在训练混合中,测试主要考察新的物体、布局、背景和指令组合,并不意味着模型能够直接控制任意从未见过的机器人。
WidowX 使用 BridgeData V2 环境,共 17 个任务,每个任务测试 10 次;Google Robot 共 12 个任务,每个任务测试 5 次。各方法尽量使用相同的起始场景和物体位置。对比包括 RT-1-X、Octo,以及 55B 参数的 RT-2-X。
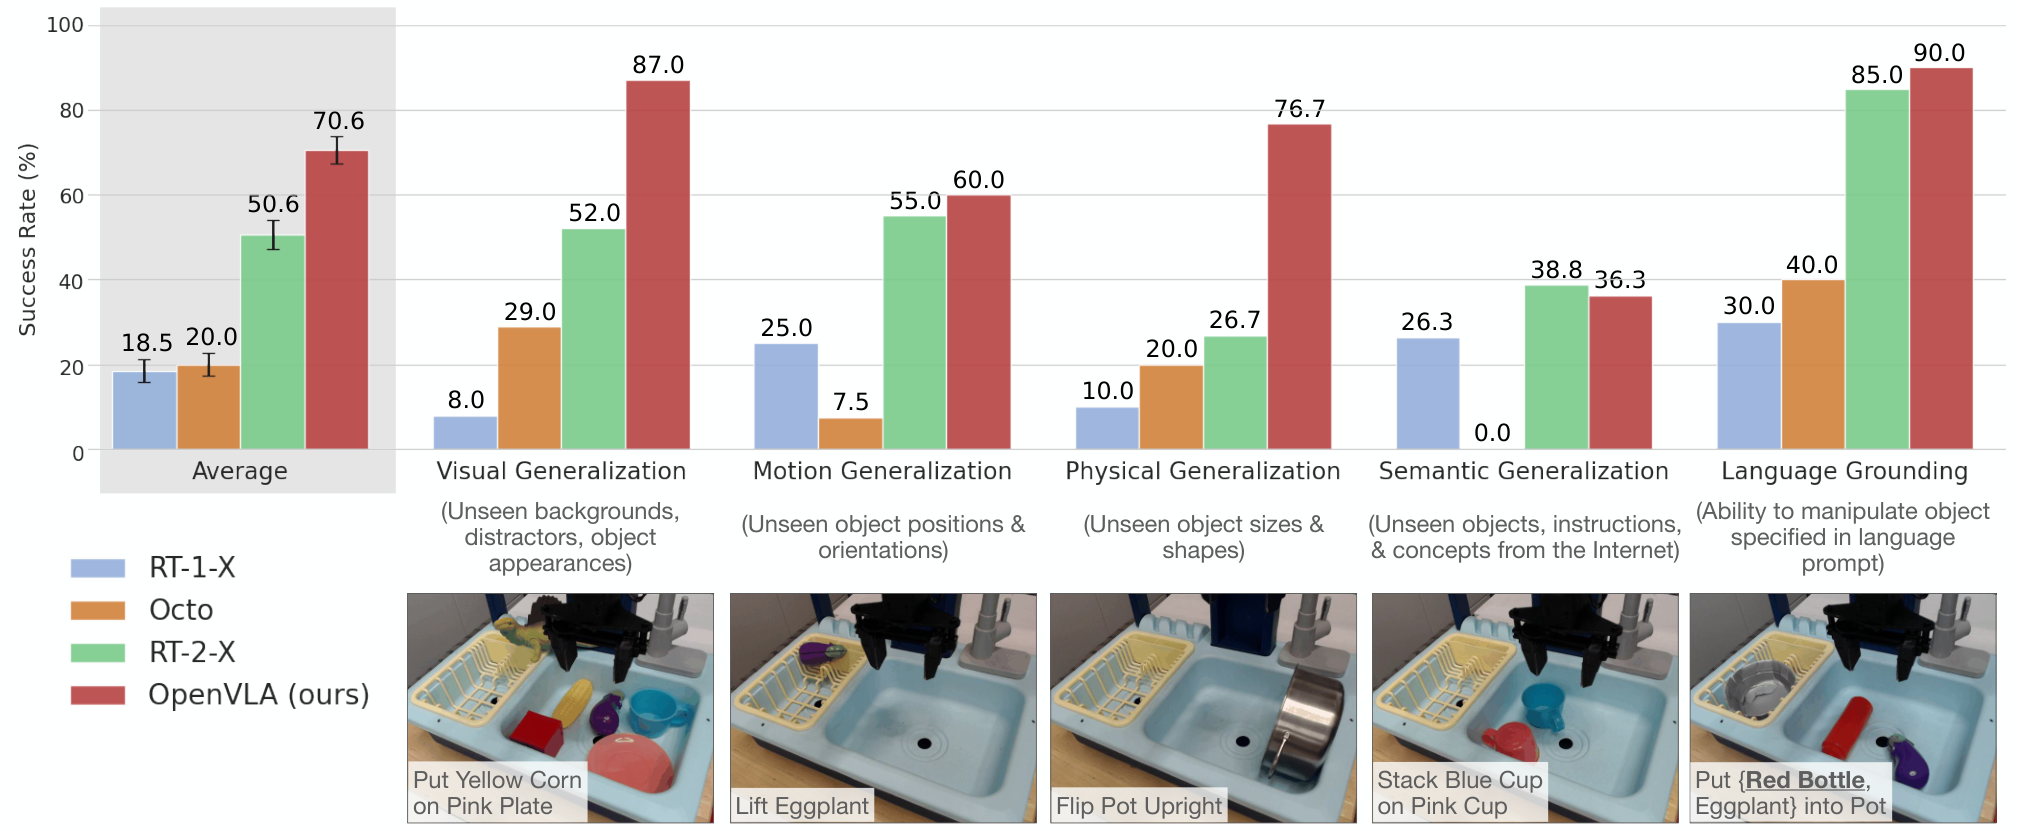
图来自原论文 Fig. 3。不同组分别改变背景、物体位置、物体形状,或要求模型理解新的语义与语言指令。
下面分别列出两套环境的结果,数值为论文报告的 success rate。部分真实机器人任务允许按完成阶段计部分分数,因而这些数值不都等于“完整任务成功次数除以试验次数”; 后为标准误。
| 方法 | WidowX / BridgeData V2 | Google Robot |
|---|---|---|
| RT-1-X | ||
| Octo | ||
| RT-2-X | ||
| OpenVLA |
结果来自附录 Table 4 和 Table 6。OpenVLA 在 Bridge 环境中比 RT-2-X 高 20 个百分点;Google Robot 上也取得更高的均值,但两者误差范围有重叠。论文摘要中的总体提升约 16.5 个百分点,对应这两套环境共 230 次试验的汇总,不能理解为每类任务都提高这么多。
从具体类别看,OpenVLA 在视觉变化、运动变化和物体形状变化下表现较好,但 语义泛化并没有全面超过 RT-2-X。作者认为,RT-2-X 使用更多互联网预训练数据,并在机器人训练中继续混合视觉语言数据,可能更有利于保留这方面的能力;OpenVLA 的机器人训练阶段则只训练动作预测。
比较时还需要注意,两个模型的机器人数据规模、视觉编码器和数据清理方式不同。OpenVLA 对 Bridge 数据开头的无效动作做了额外处理,这也是其 Bridge 表现改善的可能来源,不能将全部提升归因于更换模型主干。
新任务适配
直接评估之外,作者进一步研究:给定少量新环境的示范,OpenVLA 能否有效适配?
这里使用 Franka-Tabletop 和 Franka-DROID 两套环境,包含放置物体、倒玉米、翻锅、按语言选择物体,以及清扫桌面等七个任务。每个任务提供 10 到 150 条示范,分别涉及 5 Hz 和 15 Hz 的控制设定。
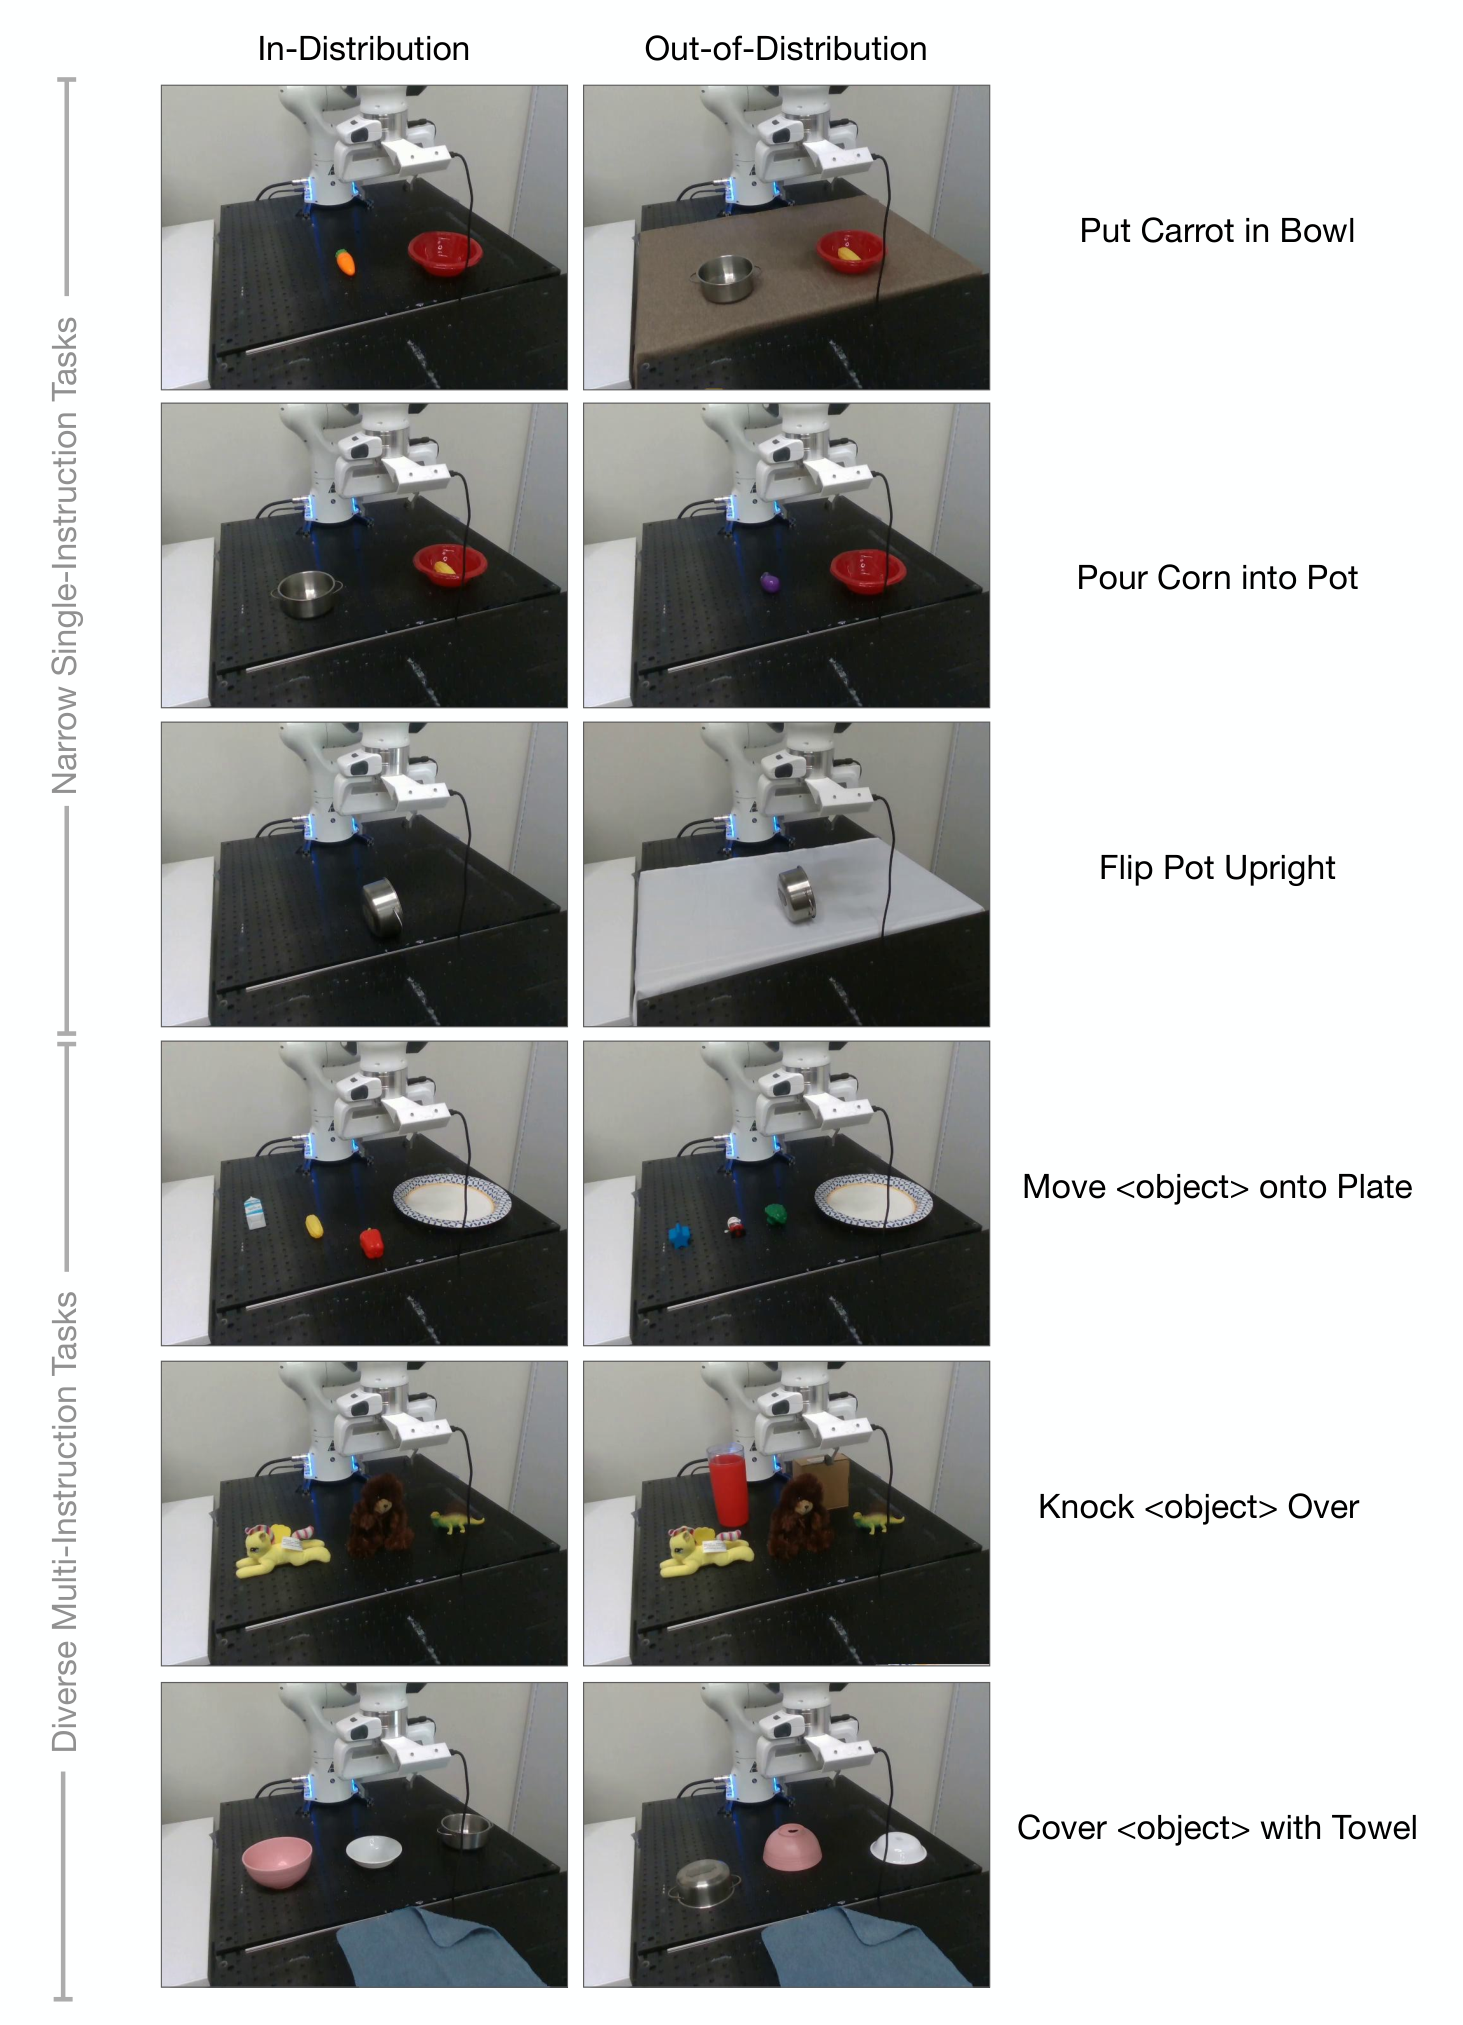
图来自原论文 Fig. 10,展示 Franka-Tabletop 的任务与测试变化;清扫桌面任务使用另一套 Franka-DROID 环境。
主要对比有:从头训练的 Diffusion Policy、微调后的 Octo,以及没有经过 OpenX 机器人预训练、直接从 Prismatic 开始训练动作的 OpenVLA(scratch)。最后这一项很重要,它可以检查收益是否只是因为使用了 VLM,而不是机器人预训练。
Diffusion Policy 还区分原始版本与 matched 版本。原始版本使用观测历史、机器人自身状态和 action chunk,预测绝对笛卡尔动作;matched 版本则与 OpenVLA 一样,只接收当前单张图像、不使用自身状态,并预测单步相对动作。因此,既需要看相近输入输出设定下的结果,也需要看更完整的 Diffusion Policy 能做到什么。
下表摘自附录 Table 7,分别统计两个环境;每种方法共进行 99 次 Tabletop 试验和 30 次 DROID 试验。
| 方法 | Franka-Tabletop | Franka-DROID |
|---|---|---|
| Diffusion Policy | ||
| Diffusion Policy(matched) | ||
| Octo | ||
| OpenVLA(scratch) | ||
| OpenVLA |
经过机器人预训练再微调的 OpenVLA 获得最高的平均表现,尤其擅长需要根据语言在多个物体和操作之间做选择的任务。与 scratch 的差距也表明, 大规模机器人数据预训练提供了额外收益,不能仅靠 VLM 本身替代。
但 Diffusion Policy 在部分固定任务中仍然更强。例如,在分布内的“把胡萝卜放进碗里”和“把玉米倒进锅里”任务中,它分别达到 90% 和 100%,OpenVLA 则为 70% 和 50%。作者也观察到 Diffusion Policy 的动作通常更加平滑和精确。因此,这些实验支持 OpenVLA 在多任务与语言条件控制中的优势,不能推出 VLA 在所有精细操作中都优于扩散策略。
LoRA
前面的新任务实验采用全参数微调,每个任务使用 8 张 A100 训练约 5 到 15 小时。作者接着研究,能否保留适配效果,同时降低微调的资源需求。
这里需要先区分实验模型: LoRA 和后面的量化实验,使用较小的机器人数据混合,以及仅含 SigLIP 的视觉编码器,与前面最终 OpenVLA 的 DINOv2 + SigLIP 结构有所不同。
LoRA 的做法是保留原来的大矩阵权重,用两个较小矩阵表示可训练的低秩增量。这样,仍然可以调整模型的计算结果,但不必为所有原始权重计算并保存梯度。本文把 LoRA 加在模型的线性层上,而不是只修改最后的动作输出层。
作者还比较了只训练最后一层、冻结视觉编码器,以及 sandwich 微调。最后一种方法仅更新视觉编码器、token embedding 和最后的 Transformer 层。下表来自 Table 1,使用两个代表性桌面任务及其分布外变化,共 33 次试验;显存统计的 batch size 为 16。
| 微调方式 | success rate | 可训练参数 | 训练显存 |
|---|---|---|---|
| 全参数微调 | 7,188.1 M | 163.3 GB | |
| 仅最后一层与 token embedding | 465.1 M | 51.4 GB | |
| 冻结视觉编码器 | 6,760.4 M | 156.2 GB | |
| Sandwich | 914.2 M | 64.0 GB | |
| LoRA, | 97.6 M | 59.7 GB | |
| LoRA, | 195.2 M | 60.5 GB |
其中,全参数微调和冻结视觉编码器的显存是 FSDP 分片到两张 GPU 后的总量。LoRA 在这组实验中与全参数微调的表现接近,而 只需训练约 1.4% 的参数。将 rank 增大到 64 没有带来明显改善,因此作者推荐默认使用 32。
这也能解释为什么“只改最后一层”并不够:新环境的适配涉及视觉表示和整个动作预测过程。冻结原始权重、但为视觉相关线性层加入可训练增量的 LoRA,仍然允许视觉特征随任务调整,与完全冻结视觉编码器不是一回事。
论文报告,LoRA 可以在单张 A100 上用约 10 到 15 小时完成新任务微调。不过,可训练参数减少,并不意味着整个模型的权重和中间激活都不再占显存;表中仍需约 60 GB,不能把“训练 1.4% 参数”理解为任意小显卡都能微调。
量化推理
微调占用之外,模型部署时还要保存权重并反复执行前向计算。作者因此比较 bfloat16、int8 和 int4 推理,检查降低权重精度能否节省显存而不损害机器人表现。
下表为 Table 2,在 8 个代表性 Bridge 任务上、每种精度共 80 次试验的结果,模型采用前面说明的 SigLIP 单编码器版本。
| 推理精度 | success rate | 显存 |
|---|---|---|
| bfloat16 | 16.8 GB | |
| int8 | 10.2 GB | |
| int4 | 7.0 GB |
int4 在这些任务中保持了与 bfloat16 接近的表现,显存则降到一半以下。但这里出现了一个看似奇怪的结果:为什么 int8 反而比精度更低的 int4 差?
原因不能只从数值精度理解。量化也会改变推理速度,新增的量化计算可能带来额外开销。在用于评估的 A5000 上,int8 只能达到约 1.2 Hz,而 int4 约为 3 Hz。Bridge 的数据采集使用 5 Hz 非阻塞控制,推理速度变慢会改变动作更新的时间间隔,进而改变实际控制过程。
作者又在阻塞控制下补做实验,即等待当前动作完成后再继续下一个动作。此时,bfloat16、int8 和 int4 的平均表现分别为 、 和 ,误差范围重叠。这支持了控制时序对前面结果的影响,而不是说明“4 bit 天然比 8 bit 更准确”。
对机器人策略而言,部署速度会直接改变策略与环境的交互。只检查离线动作预测误差,不能完整说明量化后的真实控制效果。
消融
附录还在 8 个 Bridge 任务、每种方法 80 次试验上比较数据与视觉编码器:
- 完整 OpenX 训练、双视觉编码器:;
- 只用 BridgeData V2 训练、保留双编码器:;
- 只用 BridgeData V2 训练、只保留 SigLIP:。
这组比较中,去掉 OpenX 训练的影响明显大于去掉 DINOv2。双视觉编码器能够提供帮助,但不能忽略机器人数据多样性本身的作用;而且后两个结果误差范围有重叠,不能把五个百分点的均值差距理解为已经在所有任务上验证的稳定收益。
LIBERO
除了真实机器人,作者还在 LIBERO 仿真环境中微调模型。它包含 Spatial、Object、Goal 和 Long 四组任务,分别侧重空间关系、物体变化、任务目标和长程操作。
每组原本包含 10 个任务、每任务 50 条示范。作者重新渲染高分辨率图像,清除无效动作和回放失败的示范,再用于训练。各方法都只使用第三人称相机,每组任务独立训练;OpenVLA 使用 的 LoRA。每组进行 500 次评估,并对三个随机种子取平均,因此每项结果对应共 1,500 次试验。
| 方法 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|
| Diffusion Policy | 78.3% | 92.5% | 68.3% | 50.5% | 72.4% |
| Octo | 78.9% | 85.7% | 84.6% | 51.1% | 75.1% |
| OpenVLA | 84.7% | 88.4% | 79.2% | 53.7% | 76.5% |
表中摘出 Table 12 的均值。OpenVLA 平均最好,但优势小于真实机器人适配实验,而且并非每组都领先:Object 上 Diffusion Policy 更好,Goal 上则是 Octo 更好。Long 任务的表现也说明,模型距离可靠地完成复杂长程操作还有明显差距。
作者认为,OpenVLA 的机器人预训练数据全部来自真实环境,真实与仿真之间的差异可能限制了预训练收益。这是对结果的解释,论文并没有通过加入仿真预训练数据的对照实验单独验证这一原因。
核心点和不足
OpenVLA 的核心价值,是把 预训练 VLM、跨机器人示范数据、动作 token 训练,以及可实际使用的微调和部署工具 连成一套开放流程。动作离散化和自回归预测并非它首次提出,论文更重要的贡献在于模型、数据配方和适配经验能够被后续研究使用与检验。
但它仍有几个明显限制:
- 输入有限:原始模型每次只接收一张图像,没有结合多视角、机器人自身状态和观测历史。相同的当前画面可能对应不同运动状态,仅靠单帧不总能判断。
- 推理频率有限:每步七个 token 的串行生成增加延迟,也没有利用 action chunk 一次规划多个未来动作,不适合直接承担几十 Hz 的复杂双臂控制。
- 动作精度与可靠性有限:离散输出带来量化误差,部分固定精细任务仍不及 Diffusion Policy;许多测试任务的成功率也低于 90%。
- 泛化有数据边界:已有机器人上的新场景表现,不能等同于新机器人完全免微调。新的控制方式、相机配置或任务域通常还需要示范与适配。
此外,模型大小、视觉特征选择,以及是否在机器人训练中继续混合互联网图文数据,都还没有得到充分研究。
总结
理解 OpenVLA,可以沿着一个具体过程来看:先用预训练 VLM 读懂当前图像和指令,再把机器人示范中的连续动作转换成 token,用 next-token prediction 学习;部署时生成当前动作的全部 token,恢复控制量并执行,之后根据新的观测继续预测。
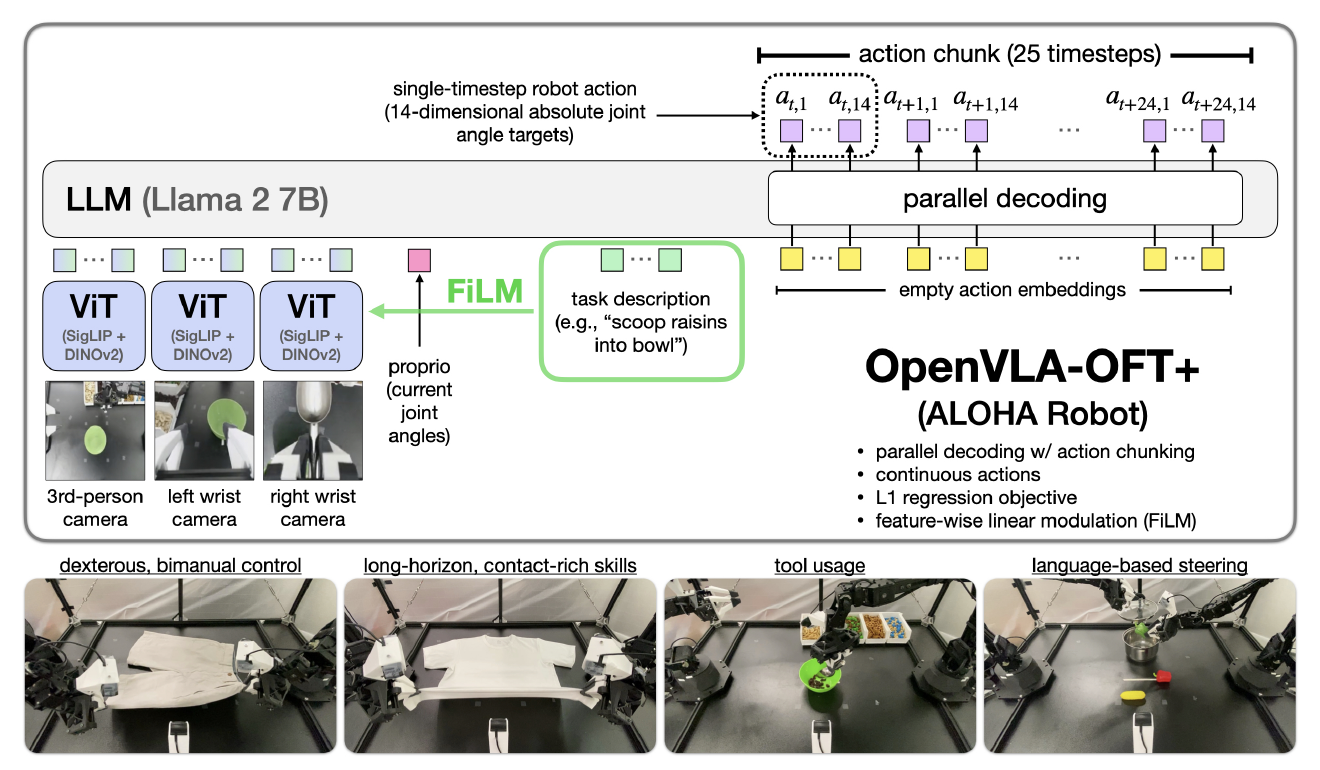
这也解释了后续工作的改进方向:如果语言模型已经能提供有用的视觉与语言表示,那么动作一定要继续逐 token、自回归、离散地输出吗?后来的 OpenVLA-OFT 笔记 正是围绕并行解码、action chunking 和连续动作回归展开,可以接着对照阅读。
参考
- OpenVLA: An Open-Source Vision-Language-Action Model,本文依据 arXiv v3,2024-09-05。
- 项目主页 与 官方代码。
- OpenVLA-7B 模型说明、动作 tokenizer 与 动作解码实现。代码链接用于补充实现细节,仓库后续扩展不等同于本篇论文的原始设定。
配图来自 Moo Jin Kim 等人的原论文 Fig. 2、Fig. 3 与 Fig. 10,原论文采用 CC BY 4.0 许可。本文由 AI 协助生成初稿,尚待个人阅读修改。