论文阅读:Neural Discrete Representation Learning
引:这篇由 Aaron van den Oord、Oriol Vinyals 和 Koray Kavukcuoglu 提出的工作,提出了 VQ-VAE(Vector Quantised Variational AutoEncoder)。它把 Encoder 输出的连续特征映射到一个可学习的离散码本,再用 Decoder 重建输入。关键问题是:离散选择不可导时,Encoder 和码本分别怎样学习?
背景
我们在 DDPM 和 DiT 中遇到过 latent:将图像映射到更紧凑的表示,再让模型在这个表示上工作。在常见的连续 VAE 中,latent 通常由高斯分布采样;而自然语言中的词、语音中的音素等对象,本身又有明显的离散结构。那么,可不可以让模型自己学习一组离散的表示?
一种直接的办法是让 Encoder 输出一个编号,再由 Decoder 根据编号恢复输入。但编号的选择是离散操作:Encoder 的输出发生很小变化时,选中的编号可能不变,也可能突然跳到另一个值。梯度怎样穿过这样的选择,成为训练时的主要障碍。
另一个问题是 posterior collapse:当 Decoder 足够强,能够根据已有输入预测数据时,普通 VAE 有可能不再使用 latent。作者希望学习一个承载信息的离散表示,并在此基础上训练生成模型。
VQ-VAE 的做法可以分成两阶段:先训练 Encoder、码本和 Decoder,把输入压缩成离散索引并恢复;再训练一个 prior,学习这些索引的分布,从而生成新的离散表示。
方法
离散 latent
首先准备一个可学习的 embedding 表,也就是 codebook(码本):
这里 是码本中向量的数量, 是每个向量的维度。Encoder 接收输入 ,输出连续特征 ;之后在码本中寻找离它最近的向量。原文用以下 one-hot 分布描述选择结果:
然后用选中的向量作为 Decoder 输入:
也就是说, 可以落在连续空间的任意位置,但 只能取码本中的某个向量。离散的是选中的索引 ;送给 Decoder 的仍然是编号对应的连续向量 。
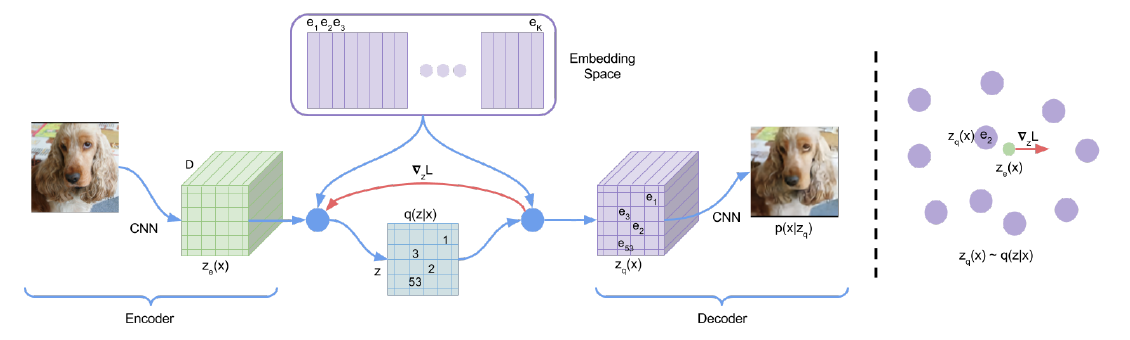
左侧是 Encoder、码本查询与 Decoder;右侧展示连续特征怎样选中最近的码本向量。图来自原论文 Fig. 1。
举个简单例子,假设一个位置的 Encoder 输出是二维向量 ,码本有 、 和 。它离 最近,因此这个位置的离散索引是 2,Decoder 实际收到的是 。Encoder 输出不必恰好等于码本向量,量化操作负责把它们对齐。
对于图像,Encoder 通常输出一张空间特征图,而不是只有一个向量。特征图上每个位置都用同一套码本查找最近邻,因此最后得到一张离散索引图。比如空间尺寸为 时,会得到 个索引,每个索引都对应码本中的一个 维向量。
训练
现在需要解决开头的问题:最近邻选择是离散的,怎样让重建误差更新 Encoder?作者采用 straight-through estimator(直通估计)。前向计算仍然把选中的 交给 Decoder;反向传播时,则近似地把 Decoder 输入处的梯度直接传给 。
可以把这个操作写成以下等价形式:
其中 是 stop-gradient:前向时保持数值,反向时阻断括号内的梯度。前向值仍然等于 ,但反向时近似把 对 的导数看作 1。这样,重建损失就能更新 Decoder,也能通过直通估计更新 Encoder。
但是,直通估计不会让重建损失直接更新被选中的码本向量。如果只训练 Encoder 和 Decoder,码本就缺少学习信号。作者因此另外加入两项距离约束,将训练目标写成:
其中 是该位置选中的码本向量。三项分别负责不同部分:
- 重建项 :评价 Decoder 能否从量化特征恢复输入,更新 Decoder,并通过直通估计更新 Encoder。
- 码本项:固定 ,将选中的 拉向 Encoder 输出,更新码本。
- Commitment loss:固定码本向量,让 Encoder 输出靠近它选中的向量。 控制这项权重,论文实验使用 。
例如前面的 选择了 ,码本项会让 向当前 Encoder 输出移动;commitment loss 则让 Encoder 的输出靠近 。两项数值形式相近,但 stop-gradient 的位置不同,所以更新的参数不同。
原论文 Eq. 3 将第一项写作 ,同时将整式称为 loss。若按通常的最小化损失约定,重建项应理解为负对数似然 ;上式采用这一约定,后两项仍按论文写法最小化。实际任务也可以使用对应的数据重建误差。
论文还提到可以用指数移动平均更新码本,但这是替代更新方式,不是该论文所报告实验的默认做法。
先验与生成
训练 VQ-VAE 时,论文使用均匀的离散先验。由于每个输入位置的后验选择是 one-hot,均匀先验下对应的 KL 项是常数,不会像连续 VAE 中那样通过这项约束鼓励后验靠近固定高斯先验。作者认为这有助于避免常见的 posterior collapse;这不意味着所有离散码本都必然被充分使用。
但现在还有一个问题:Encoder 需要真实输入,怎样从头生成一个新样本? 如果只是独立随机抽取码本索引,相邻位置之间就没有学到的结构关系。作者在 VQ-VAE 训练完成后,先把训练数据编码成离散索引,再训练一个自回归 prior 来学习这些索引的联合分布。
生成图像时,论文使用 PixelCNN 逐位置采样离散索引;接着把索引查回对应的码本向量,送入已经训练好的 Decoder。训练重建模型和训练 prior 是分开的两个阶段。前者回答“怎样把现有输入表示成码本索引”,后者回答“怎样生成一组彼此协调的索引”。论文在音频任务中则使用 WaveNet 建模 prior。
实验
连续与离散表示
作者首先在 CIFAR10 上比较连续 VAE、VQ-VAE 和 VIMCO,使用相近的基础 Encoder/Decoder 结构。论文报告的 bits/dim 数值分别为:
| 方法 | bits/dim ↓ |
|---|---|
| 连续 VAE | 4.51 |
| VQ-VAE | 4.67 |
| VIMCO | 5.14 |
这些数值基于论文对似然下界的评估,并非精确的负对数似然。这里 VQ-VAE 接近连续 VAE,但没有超过它。这个结果支持论文的一个主要结论:在这一设置下,离散 latent 也可以取得与连续表示接近的似然表现。
图像
在 ImageNet 图像实验中,作者将 图像编码为 的索引图,码本大小 。每个位置的索引需要 9 bit 表示,因此按论文的简单位数计算:
这里的原始像素位数约为离散索引位数的 42.7 倍;这是表示大小的粗略比较,没有将模型参数、码本存储和实际熵编码开销计入。
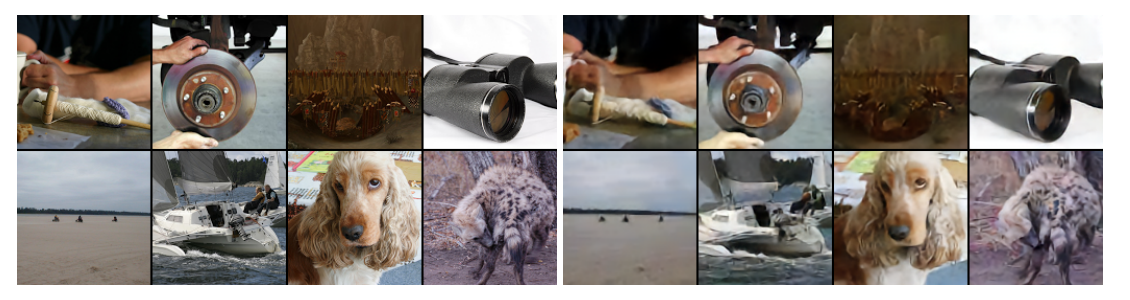
左侧是原图,右侧是重建结果,来自原论文 Fig. 2。
论文还训练 PixelCNN prior,再从索引空间采样并解码得到新图像。这里要区分:上图是已有图像经 Encoder 的重建;prior 采样得到的则是不依赖某张输入图像的新样本。
音频与视频
在语音实验中,作者将连续波形压缩成更低时间分辨率的离散序列,并让 Decoder 同时接收 speaker ID。改变 speaker ID 后,解码结果可以保留原语音内容,同时呈现另一位说话人的声音。这说明离散表示与说话人条件可以在一定程度上承担不同信息。
作者还用真实音素标签分析离散码,但这些标签没有参与 VQ-VAE 训练。在一种实验设定下,将码值映射到最常对应的音素后,分类准确率为 49.3%,对照基线为 7.2%。这个结果说明码值与音素有关,但不能直接等同于完整的语音识别系统。
视频实验中,模型在离散 latent 空间生成后续状态,再将其解码为图像帧。它展示了同一种离散表示也可以用于时间序列,而不只用于静态图像。
核心点和不足
VQ-VAE 将连续特征与离散索引接起来:Encoder 产生连续向量,最近邻查找把它映射为码本索引,Decoder 再读取对应向量。直通估计、码本项和 commitment loss 分别处理梯度传播与码本对齐,让这条路径能够训练。
这种设计也留下了几个问题。首先,码本容量 、向量维度 和 latent 的空间分辨率共同影响压缩程度与表达能力。其次,最近邻选择本身不可导,直通估计只是训练时使用的梯度近似。最后,量化后的索引只是表示,能否生成有结构的新样本,还取决于后续 prior 学到了什么。
总结
VQ-VAE 先把输入映射为离散索引,再通过码本和 Decoder 重建;生成时则由学习到的 prior 产生索引,随后解码成数据。离散索引负责选择,码本向量负责提供 Decoder 可以使用的连续特征。
从这里回到 DiT,可以看到两种不同的 latent:VQ-VAE 使用离散码本索引,而 DiT 论文使用预训练 VAE 得到的连续空间特征。二者都通过压缩表示减轻后续建模负担,但表示形式和生成方式不同。
参考
- 原论文:Neural Discrete Representation Learning,本文依据 arXiv v2。
- 作者的音频样例:可听重建和说话人转换结果。
- 文中图像裁自原论文 Fig. 1–2。
- AI 协助生成初稿。