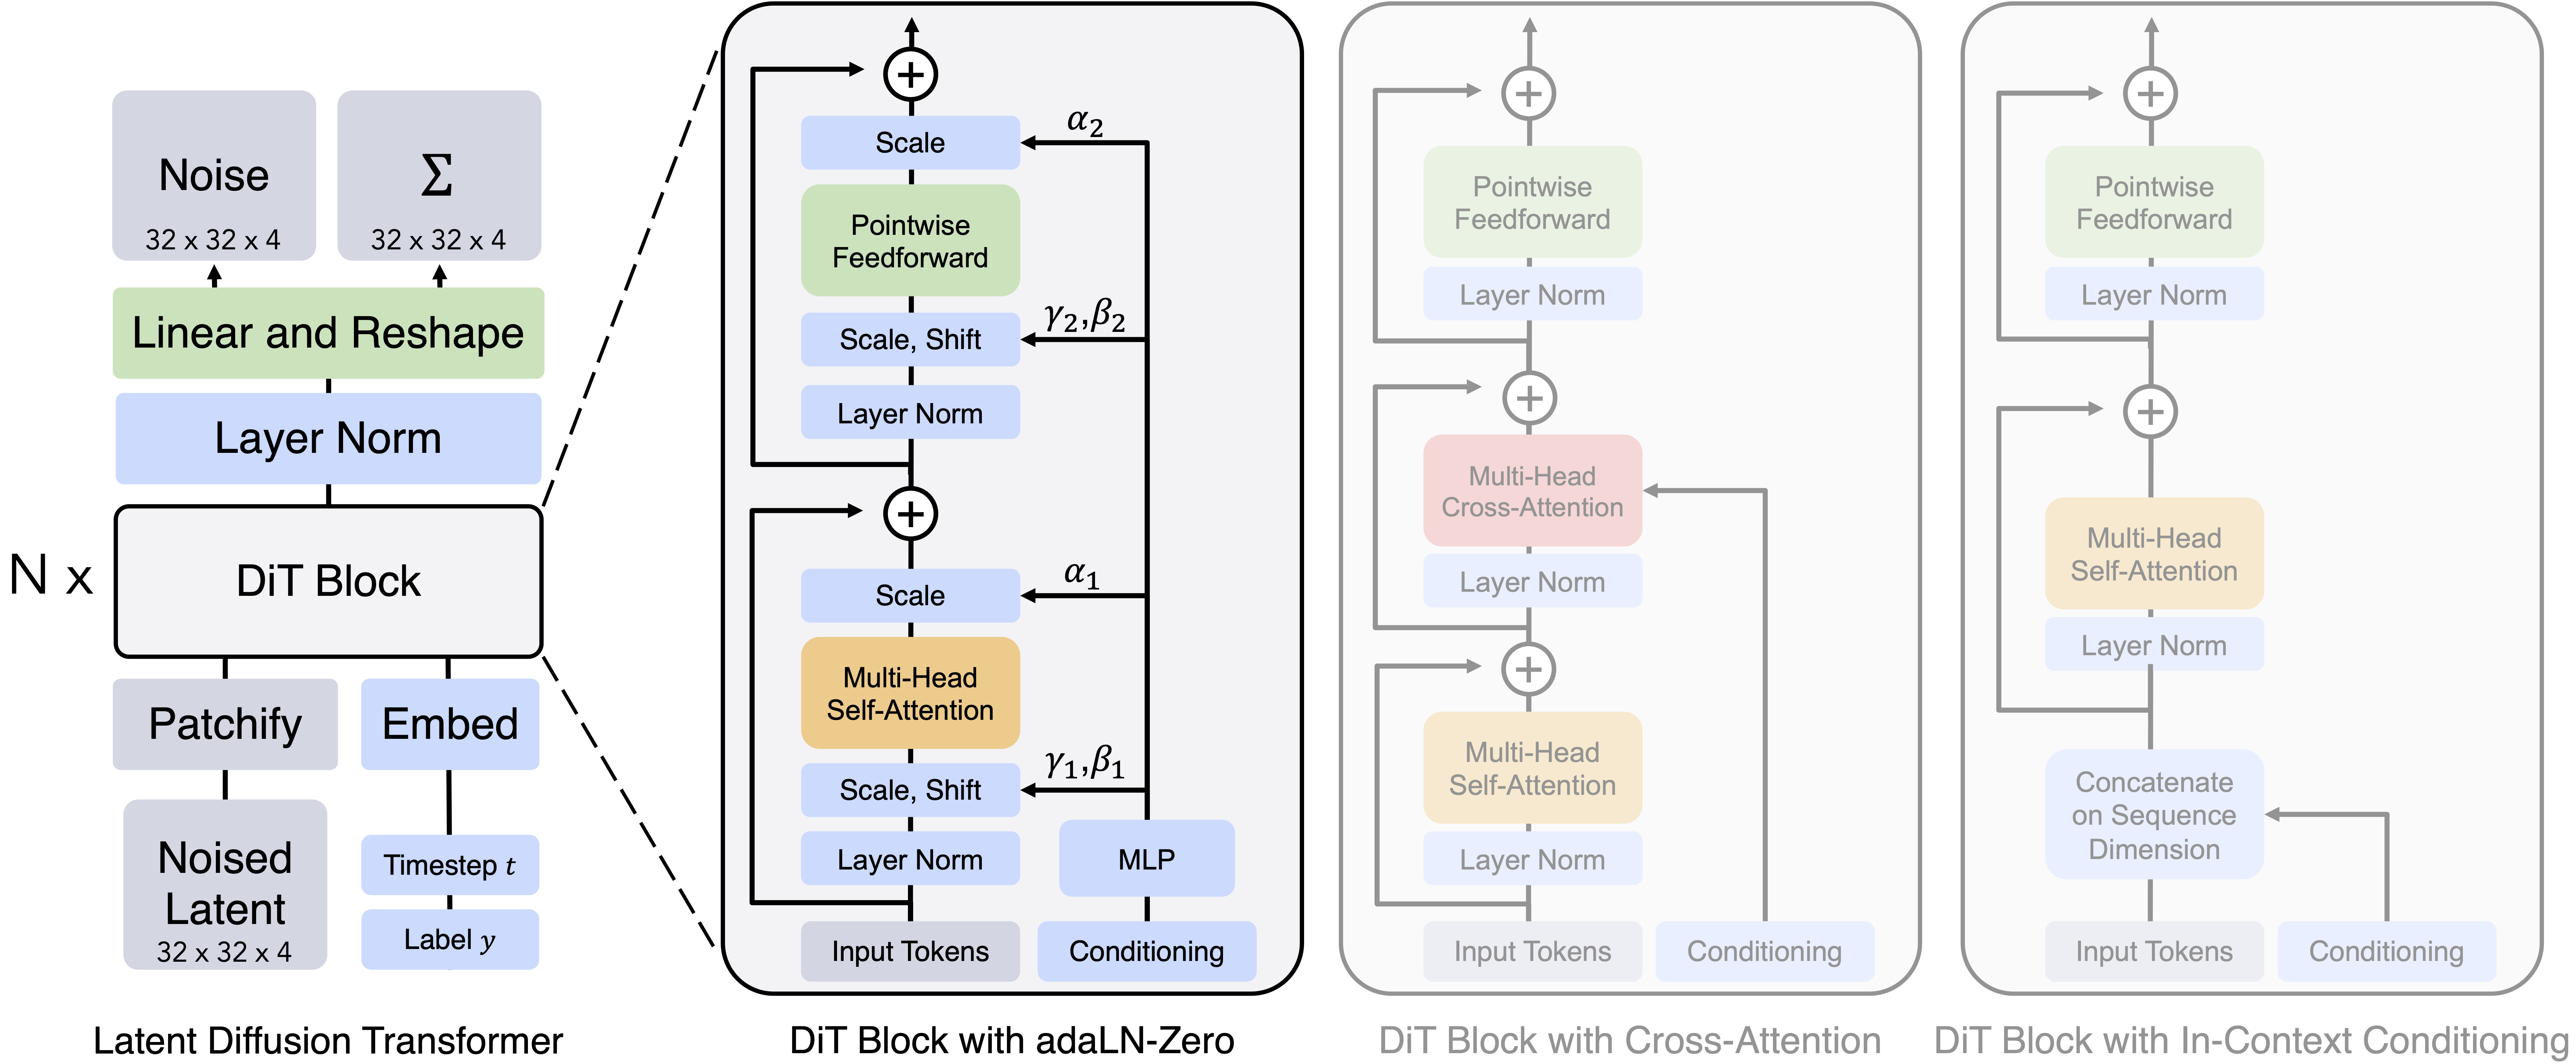
引:DDPM 是 Jonathan Ho、Ajay Jain 和 Pieter Abbeel 在 2020 年提出的工作。它用一个固定的加噪过程构造不同难度的去噪任务,再学习反向过程,从纯高斯噪声逐步生成图像。本文最关键的部分是:怎样将反向分布的学习转化为噪声预测,以及为什么最终可以用一个简单的均方误差训练生成模型。 理解这条推导,也就能理解后来 DiT 等工作中噪声预测目标的来源。
背景
我们可以先想象一张清晰图像:如果不断往其中加入少量随机噪声,图像的细节会逐渐消失,最后几乎只剩噪声。这个破坏过程很容易实现,因为每次加入什么噪声、加入多少,都可以由我们自己决定。
DDPM 要做的是学习与之对应的生成过程:给模型一张噪声图,让它逐步得到噪声更少的状态,最终产生一张自然图像。这里学习的是数据的分布,模型需要知道什么样的图像结构是合理的,以及在当前噪声水平下应该怎样更新输入。
扩散概率模型在本文之前已经被提出。DDPM 的贡献在于,通过一套具体的参数化和训练目标,让这类模型得到了很好的图像生成效果,并说明了它与 Denoising Score Matching 和 Langevin Dynamics 的联系。
为了看懂它,我们需要把三个问题接起来:
- 怎样定义加噪过程,并高效地构造训练输入;
- 怎样利用这个已知过程,为反向生成提供监督;
- 为什么监督最后会变成“预测加入的高斯噪声”。
预备知识
似然
给定一份已经观测到的数据 x,将 pθ(x) 看作关于模型参数 θ 的函数,就得到似然。训练生成模型时,希望真实数据在模型下的似然较高。通常先取对数,再取负号,把最大化似然改成最小化负对数似然。
有时 pθ(x) 包含无法直接算出的积分。这时可以构造一个容易计算的对数似然下界,称为 ELBO;取负号后,它就成为负对数似然的上界。DDPM 使用的工具是 Jensen 不等式:对正随机变量 X,因为 −log 是凸函数,所以
−logE[X]≤E[−logX].
也就是说,先求平均再取负对数,结果不会大于先取负对数再求平均。这个上界与真实目标可能有间隙,但可以作为训练时的替代目标。
KL 散度。 要比较两个概率分布 q 和 p,可以使用 Kullback–Leibler divergence:
DKL(q∥p)=Ex∼q[logp(x)q(x)].
它非负,两个分布相同时为零;交换 q,p 后一般得到不同的值。对于两个一维高斯分布,KL 可以直接计算:
DKL(N(μ1,σ12)∥N(μ2,σ22))=21logσ12σ22+2σ22σ12+(μ1−μ2)2−21.
如果两个方差固定,而我们要学习第二个分布的均值,那么上式中只有 (μ1−μ2)2 与待学习的均值有关。因此,最小化这两个高斯分布的 KL,就变成了拟合均值。这会在后面用来理解噪声预测损失。
Score 与 Langevin dynamics。 Score 是对数概率密度对输入的梯度,指出从当前位置向哪个方向移动可以增大密度。以一维高斯分布为例,均值右侧的 score 为负、左侧为正,都指向密度更高的中心。Score matching 学习这个梯度场;denoising score matching 利用加噪数据的条件分布来训练。Langevin dynamics 的基本更新包含沿 score 方向移动和加入高斯噪声两部分,后面会看到它与 DDPM 采样的联系。
概率模型
设真实图像为 x0∼q(x0),x1,…,xT 是与图像同维度的中间变量;θ 表示神经网络参数。粗体表示向量或整个图像张量,I 是单位矩阵。本文在像素空间进行扩散,这些中间变量不是 VAE 编码后的 latent。
作者先定义生成模型,也就是 reverse process(反向过程)。从标准高斯先验 p(xT)=N(xT;0,I) 出发,逐步生成图像:
pθ(x0:T)pθ(xt−1∣xt)=p(xT)t=1∏Tpθ(xt−1∣xt),=N(xt−1;μθ(xt,t),Σθ(xt,t)).(1)
这里的 pθ(xt−1∣xt) 描述:已经知道当前带噪图像时,前一个状态可能在哪里。均值 μθ 决定这个分布的中心,协方差 Σθ 决定各维度的波动及相关性。它们都可以依赖当前输入和时间步,后面再讨论具体怎样由网络确定。
第一行将这些单步转移连起来,得到的是一整条生成轨迹的联合分布。这里使用了马尔可夫假设:给定当前状态,下一次转移不再额外依赖更早的状态,因此可以把轨迹的联合概率分解为初始分布与各步条件分布的乘积。
与之配套, forward process(前向过程) 从真实图像出发,按照噪声方差序列 β1,…,βT 逐步加噪。βt 决定第 t 步新加入的噪声有多大,这一整套安排称为 variance schedule:
q(x1:T∣x0)q(xt∣xt−1)=t=1∏Tq(xt∣xt−1),=N(xt;1−βtxt−1,βtI).(2)
举个例子,单个像素值经过这一步,就变成原值的 1−βt 倍,再加上一份标准差为 βt 的高斯噪声。对整张图像也是同样的操作;βtI 表示给定上一张图像时,各分量新加入的噪声相互独立、方差都是 βt。
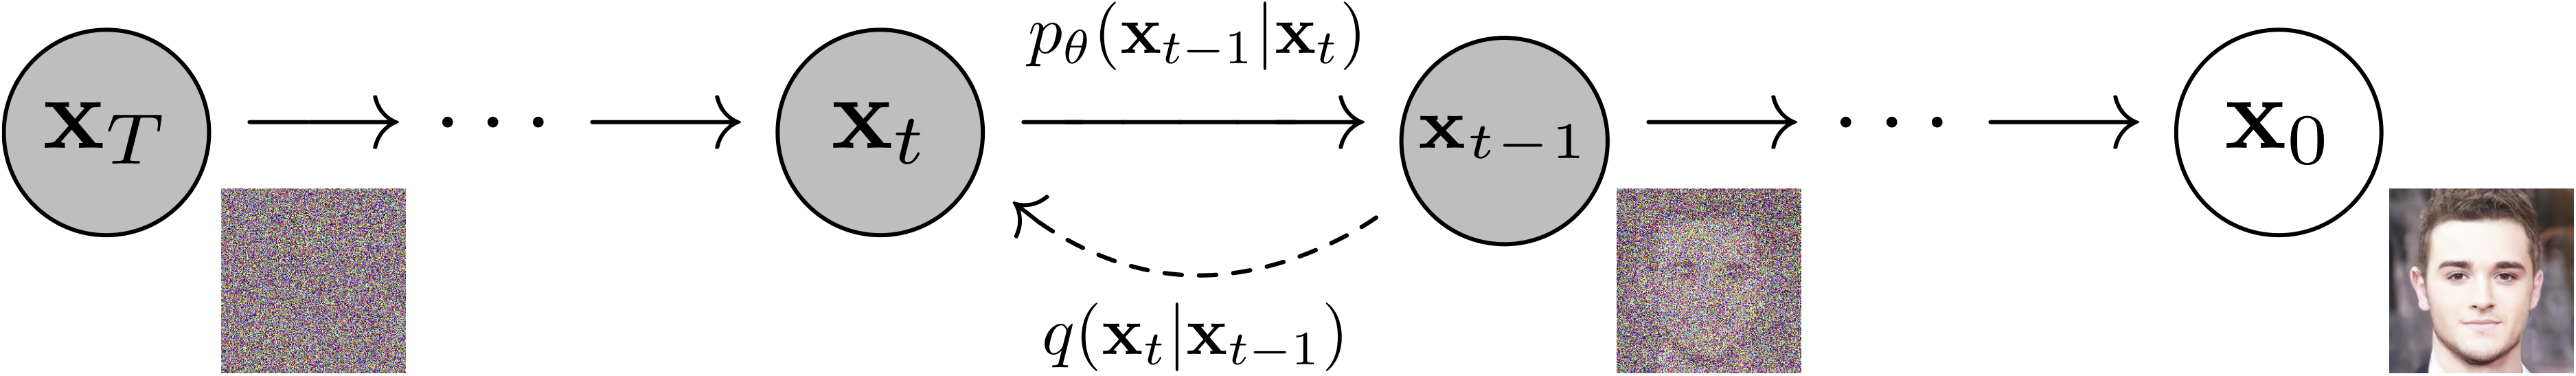
图来自作者项目页,对应原论文 Fig. 2。q 从数据走向噪声,pθ 从噪声走向数据。
训练目标
现在我们已经规定了模型怎样从噪声生成图像,但还没有解决训练问题:什么样的参数 θ 才算学得好? 一个自然的标准是,让模型给数据集中真实出现的图像分配更高的概率。
对单张真实图像,模型给出的 pθ(x0) 就是我们关心的似然;对整个数据分布,我们希望降低平均负对数似然 E[−logpθ(x0)],实践中用数据集的样本平均估计。连续变量中使用概率密度,离散像素的概率则会在最后一步解码时处理。
但是 Eq. 1 能直接给出的是“图像加上整条中间轨迹”的联合分布。同一张最终图像可能经过许多不同的中间轨迹生成,我们只关心这张图像时,就要把这些可能性全部加起来,也就是用积分:
pθ(x0)=∫pθ(x0:T)dx1:T.
这个操作叫作边缘化。每个中间状态都与整张图像一样大,又有很多个时间步,因此直接计算这个高维积分很困难。单步转移分布容易计算,不代表最终图像的边缘似然也容易计算。
前向过程这时就有了训练上的用途:给定真实图像,我们很容易按 q(x1:T∣x0) 构造中间轨迹。在上面的积分中乘上再除以前向分布,可以将固定图像的似然改写为期望:
pθ(x0)=Eq(x1:T∣x0)[q(x1:T∣x0)pθ(x0:T)].
现在对这个期望应用预备知识中的 Jensen 不等式,再对真实图像取平均,就得到负对数似然的上界 L:
E[−logpθ(x0)]≤Eq[−logq(x1:T∣x0)pθ(x0:T)]=L.(3)
这里左侧仍然是我们希望降低的真实数据负对数似然;右侧是在真实图像和前向加噪轨迹上取平均的另一个目标。训练时可以从数据取图、按前向过程采样轨迹,再计算右侧的量来更新 θ,无需先求出左侧那个困难的积分。
有了训练目标,还需要解决怎样高效构造输入、怎样评价某一步的预测。前向过程的高斯结构恰好让这两件事都能进一步简化。
加噪采样
接着定义 αt=1−βt、αˉt=∏s=1tαs。前向过程有一个关键性质:可以直接采样任意时间步,无须先依次生成全部中间状态:
q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I).(4)
也就是 xt=αˉtx0+1−αˉtϵ,其中 ϵ∼N(0,I)。这份噪声与图像同形状,表示多步加噪合并后的随机扰动。训练若只需要第 t 步的输入,就可以用这条式子直接生成它,不必从第 1 步逐次加噪。
我们可以用前两步来理解多步噪声怎样合并。设这两步分别使用独立的标准高斯噪声 ϵ1,ϵ2,展开得到:
x2=α2α1x0+α2β1ϵ1+β2ϵ2.
后两项的协方差相加为 (α2β1+β2)I=(1−α1α2)I。由于两份噪声相互独立,交叉协方差为零;继续展开就得到 Eq. 4。
损失分解
现在我们能方便地得到某个时间步的带噪图像,但 Eq. 3 的目标还写成整条轨迹的概率比值。要把训练落实到每一步,接下来需要将它拆成对各个反向分布的评价。
直观上,模型给出 pθ(xt−1∣xt),我们希望知道它与正确的上一步分布有多大差别。训练时,产生当前状态的原图 x0 是已知的,因此可以利用 q(xt−1∣xt,x0) 提供监督。这里多出的 x0 是训练信息,不会作为生成时的输入。
这里就可以用预备知识中的 KL 散度:把已知的训练分布放在 q 的位置,把模型预测放在 p 的位置,通过最小化 KL 来训练反向分布。
具体地,将 Eq. 1、2 的乘积代入 Eq. 3,乘积的对数变成各时间步的求和。再用贝叶斯公式将前向转移改写为给定 x0 的反向后验,就可以把同一个 L 整理为下面三部分。这种整理也减少了直接采样整条轨迹来估计损失时的波动:
L=Eq[LTDKL(q(xT∣x0)∥p(xT))+t=2∑TLt−1DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))L0−logpθ(x0∣x1)].(5)
这个式子没有另换一个目标,而是将 Eq. 3 的 L 分解成了三类任务:
- LT:终点与先验。 从真实图像加噪得到的终点分布,要与生成时使用的标准高斯先验对得上。
- Lt−1:中间步骤。 对 t>1,用 KL 比较给定原图时的反向后验与模型预测的反向分布。这部分最终会导出均值预测和噪声预测的损失。
- L0:最后一步。 直接评价模型从 x1 恢复真实图像 x0 的概率,因此是一个负对数似然项。
这样,我们就知道每个反向步骤要学什么了。后面的方法设计将分别处理这三类项,而训练可以随机抽取时间步来估计其中的求和,不必每次运行完整生成链。
反向后验
Eq. 5 中间项的监督分布为什么能得到,还需要进一步说明。只给一张带噪图像 xt,它可能来自很多原图;但训练时,我们还知道它是由哪一张 x0 加噪得到的。
举个例子,若某个像素加噪后的值是 0.3,单凭这个数不能确定它此前是什么;同时知道原图的像素值,就能缩小上一步状态的可能范围。q(xt−1∣xt,x0) 描述的正是这种同时知道当前状态和原图之后,上一步状态的条件分布。
由于前向过程是线性高斯链,这个后验仍然是高斯分布,且均值、方差可以精确计算:
q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI),t>1.(6)
其中:
μ~t(xt,x0)β~t=1−αˉtαˉt−1βtx0+1−αˉtαt(1−αˉt−1)xt,=1−αˉt1−αˉt−1βt.(7)
这些式子来自贝叶斯公式:
q(xt−1∣xt,x0)∝q(xt∣xt−1)q(xt−1∣x0).
右侧第一项由 Eq. 2 给出,表示候选的上一步状态能以多大密度产生当前状态;第二项由 Eq. 4 给出,表示这张原图加噪到上一步时的分布。将两项相乘、合并高斯指数中的二次项并配方,就得到 Eq. 6–7。∝ 表示相差一个不依赖 xt−1 的归一化常数。
这就为训练提供了一个能计算的分布目标。 模型只接收 xt,t,训练代码则利用额外已知的 x0 算出监督分布,并通过 Eq. 5 的 KL 项评价预测。生成时没有原图,就使用模型学到的反向分布逐步采样。
方法
有了概率模型和变分目标,接下来就要决定:哪些量固定、网络预测什么,以及最后用什么损失训练。
前向过程
作者将前向噪声方差序列 β1,…,βT 固定为超参数,不通过训练学习。这样,整个前向过程 q 没有可学习参数,而先验 p(xT) 也固定,所以 LT 与 θ 无关,可以在优化模型参数时忽略。
这里忽略的是一个不影响参数更新的常数项,并非要求 LT 严格为零。只要 αˉT 足够小,Eq. 4 中原始信号的贡献就很小,前向终点也就接近标准高斯先验。具体采用的 T 与 βt 数值放在实验设置中交代。
反向过程
这一节处理 1<t≤T 的中间反向步骤。作者先将 Eq. 1 中的一般协方差固定为随时间变化的各向同性方差:
Σθ(xt,t)=σt2I.
论文考察了 σt2=βt 和 σt2=β~t,两种选择得到相近的结果。因此,原始 DDPM 的主要设计中,网络不需要输出协方差,接下来重点解决均值怎样参数化。
均值预测
现在回到 Eq. 5 的中间项。我们已经能利用真实图像算出监督分布的均值 μ~t 与方差 β~tI,模型则给出自己的均值 μθ 和固定方差 σt2I。训练需要比较的就是这两个高斯分布。
两个分布都是高斯分布,可以使用预备知识中的高斯 KL 公式。由于两边的方差都不参与学习,只有均值差的平方依赖 θ。因此,优化这个 KL 就转成了拟合均值;对各个图像分量求和,均值差的平方和变成向量平方范数。
对数据和前向噪声取期望,把与 θ 无关的部分合并为 C,得到:
Lt−1=Eq[2σt21∥μ~t(xt,x0)−μθ(xt,t)∥2]+C.(8)
C 是与 θ 无关的项。最直接的做法就是让网络预测后验均值 μ~t,但作者接着把这个目标改写为噪声预测。
重参数化
利用 Eq. 4 的重参数化,令 xt(x0,ϵ)=αˉtx0+1−αˉtϵ,可以反解出 x0=(xt−1−αˉtϵ)/αˉt。下面为缩短公式,将这个 xt(x0,ϵ) 简写为 xt,代入 Eq. 8:
Lt−1−C=Ex0,ϵ[2σt21μ~t(xt,αˉtxt−1−αˉtϵ)−μθ(xt,t)2].(9)
再将 Eq. 7 的后验均值展开。xt 的系数合并为 1/αt,ϵ 的系数合并为 −βt/(αt1−αˉt),于是得到:
Lt−1−C=Ex0,ϵ[2σt21αt1(xt−1−αˉtβtϵ)−μθ(xt,t)2].(10)
也就是说,模型要预测的均值已经能写成“当前输入加上真实噪声的线性变换”。xt 已经给了网络,其他系数由日程确定,因此可以让网络只负责估计 ϵ。
噪声预测与采样
用 ϵθ(xt,t) 代替未知的噪声,就定义了模型的均值函数:
μθ(xt,t)=αt1(xt−1−αˉtβtϵθ(xt,t)).(11)
网络直接输出噪声预测,采样程序据此计算反向均值。 例如输入是 32×32×3 的带噪图像,输出也是同形状的噪声预测。均值并没有被省略,而是通过这个参数化间接得到。
生成时先采样 xT∼N(0,I),再按原文 Algorithm 2,从 t=T 到 1 依次更新:
xt−1=αt1(xt−1−αˉt1−αtϵθ(xt,t))+σtz.
其中 t>1 时 z∼N(0,I),t=1 时 z=0。z 是反向采样时新抽取的随机噪声,与前向加噪的 ϵ 作用不同,也不是 DiT 中的图像 latent。
这一步先根据预测噪声算均值,再按照固定方差采样。生成时必须逐步得到前一个状态,与训练时可以直接构造任意 xt 不同。
加权噪声损失
将 Eq. 11 代入 Eq. 10,两个均值中的 xt 抵消,只留下真实噪声与预测噪声之差。原文 Eq. 12 对应:
Lt−1−C=Ex0,ϵ[2σt2αt(1−αˉt)βt2⋅ϵ−ϵθ(αˉtx0+1−αˉtϵ,t)2].(12)
到这里,训练反向分布已经转成了加权噪声 MSE。作者还从另一个角度解释这个结果:它与多个噪声水平上的 denoising score matching 有联系。
为什么噪声预测能与 score 联系起来?对 Eq. 4 的高斯扰动分布取对数,再对 xt 求导,就有:
∇xtlogq(xt∣x0)=−1−αˉtxt−αˉtx0=−1−αˉtϵ.
因此,预测噪声经过尺度换算后就对应一个 score 估计。网络只接收 xt,t,MSE 的最优预测会对可能产生当前输入的噪声进行条件平均,对应加噪数据边缘分布的 score。这个公式是帮助理解的补充推导;原文在 Eq. 12 后指出,噪声预测目标类似去噪 score matching,配套的采样链则类似 Langevin dynamics。
到这里,预测均值与预测噪声是反向过程的两种参数化;仅做这次改写,并没有去掉 Eq. 12 的时间步权重。原文随后通过实验比较这些选择。
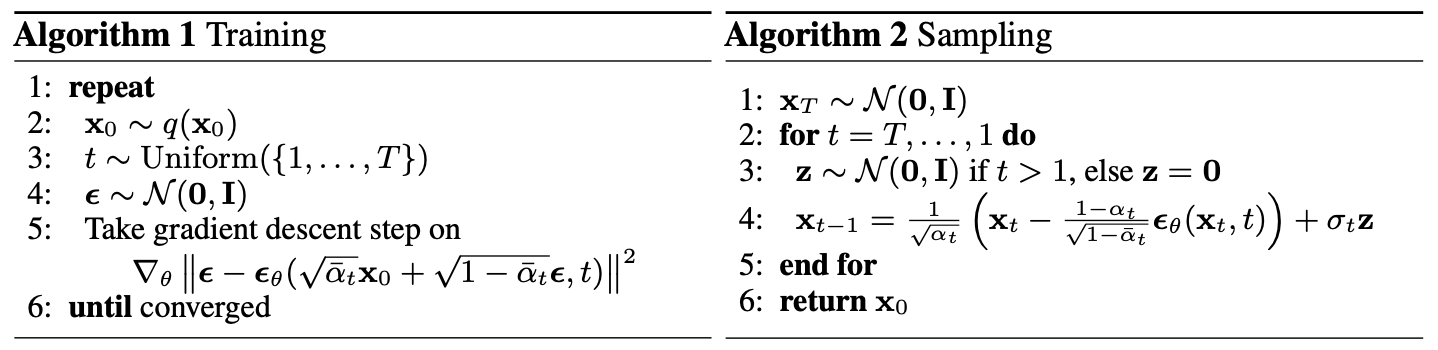
图来自作者项目页,对应原论文 Algorithm 1–2。Algorithm 2 使用上面的均值参数化;Algorithm 1 采用的简化训练目标将在后面说明。
数据缩放与解码
前面处理的是 t>1 的中间步骤。最后一步要从 x1 输出真实图像,其训练项是 L0=−logpθ(x0∣x1)。这里还要处理一个实际问题:图像的像素是离散整数,高斯分布却是连续的。
作者先将 {0,1,…,255} 的像素线性缩放到 [−1,1],相邻像素值的间隔因此是 2/255。为了给一个离散像素值分配概率,不能只取高斯密度在该点的数值,而要对这个像素对应的区间积分。原文定义:
pθ(x0∣x1)=i=1∏D∫δ−(x0i)δ+(x0i)N(x;μθi(x1,1),σ12)dx,(13)
其中 D 是图像全部标量分量的数量,上标 i 表示取第 i 个分量。积分边界为:
δ+(x)={∞,x+2551,x=1,x<1,δ−(x)={−∞,x−2551,x=−1,x>−1.
举个例子,整数像素 128 缩放后是 1/255,对应的积分区间就是 [0,2/255],半宽为 1/255。最小、最大像素则分别接收高斯分布两侧的尾部概率,让全部离散取值的概率加起来为 1。
这里的 decoder 指最后一步将连续高斯分布转换为离散像素概率的规则,不是另外接一个 VAE Decoder。这个定义使 L0 能用于离散图像的似然与编码长度计算;实际生成结束时,作者直接显示 μθ(x1,1),不再加入随机噪声。
简化训练目标
至此,Eq. 12 的中间项和 Eq. 13 的最后一步解码已经确定,完整变分目标可以直接用于训练。不过,作者发现改用下面的目标,生成图像的效果更好,实施起来也更简单:
Lsimple(θ)=Et,x0,ϵ[ϵ−ϵθ(αˉtx0+1−αˉtϵ,t)2].(14)
其中 t∼Uniform({1,…,T}),x0∼q(x0),ϵ∼N(0,I)。这个目标与完整变分目标的关系,需要分别看:
- t>1 时,去掉了 Eq. 12 中随时间变化的系数 βt2/[2σt2αt(1−αˉt)]。
- t=1 时,不再精确计算 Eq. 13 的离散积分;原文将其联系到“高斯密度乘区间宽度”的近似,再忽略固定方差相关系数及边界效应。
- LT 与 θ 无关,不参与参数优化。
所以,Lsimple 改变了各时间步在原始目标中的相对权重。在本文的日程设置下,它相对降低了小 t、噪声很少的去噪任务的权重,将优化重点更多分配给较大噪声下的任务。生成质量上的好处要由后面的实验支持。
原文 Algorithm 1 的训练过程可以直接整理为:
- 取真实图像 x0,将像素缩放到 [−1,1];
- 均匀采样时间步 t,采样同形状的标准高斯噪声 ϵ;
- 用 Eq. 4 的重参数化直接构造 xt;
- 将 xt,t 输入网络,得到 ϵθ(xt,t);
- 计算 Eq. 14 的噪声 MSE,反向传播更新 θ。
同一网络在所有时间步共享参数,一次训练更新只处理随机选中的时间步;生成时才需要按 Algorithm 2 依次运行反向链。这里就把概率模型、均值参数化、训练监督与最终采样接起来了。
实验
数据与基本设定
作者在 CIFAR10 的 32×32 图像,以及 CelebA-HQ、LSUN 的 256×256 图像上验证模型。所有实验采用 T=1000,前向噪声方差从 β1=10−4 线性增加到 βT=0.02,主要模型使用固定的反向方差。
反向网络采用 U-Net,使用 GroupNorm,在 16×16 特征图上加入 self-attention。所有时间步共享参数,时间步通过正弦、余弦 embedding 输入网络;主要图像生成实验为无条件生成。
实现补充:官方代码会先从噪声预测计算 x^0,裁剪到 [−1,1],再用它计算反向后验均值。
本文关注的主要指标为:
- FID:比较生成图像与真实图像在特征空间中的分布差异,越低越好;
- Inception Score(IS):根据分类器输出衡量样本的可辨识性和类别多样性,越高越好;
- Negative Log-Likelihood(NLL):评价模型对数据分配的概率,以 bits/dim 报告,越低越好。论文通过变分目标计算其上界。
图像生成效果
下面摘出原论文 Table 1 中的部分无条件 CIFAR10 结果。该表的 FID 采用训练集作为真实数据参照:
| 方法 |
IS ↑ |
FID ↓ |
NLL(bits/dim)↓ |
| NCSN |
8.87±0.12 |
25.32 |
— |
| StyleGAN2 + ADA(v1) |
9.74±0.05 |
3.26 |
— |
| DDPM,原始变分目标 L |
7.67±0.13 |
13.51 |
≤3.70 |
| DDPM,Lsimple |
9.46±0.11 |
3.17 |
≤3.75 |
使用简化噪声预测目标后,DDPM 得到了 3.17 的 FID,展示了扩散模型生成高质量图像的能力。在更高分辨率的 LSUN 数据上,论文报告 Church 的 FID 为 7.89,Bedroom 为 4.90,并展示了相应的生成样本。
表中也能看到,生成质量和似然指标对训练目标的响应不同:原始变分目标取得更好的 NLL 上界,简化目标则显著改善 FID。这与前面的推导对应——去掉时间步权重会改变优化重点,而不仅是换一种形式写同一个损失。
消融实验
原论文 Table 2 进一步比较了反向过程的参数化。下面三项都使用固定的各向同性方差:
| 预测对象 |
训练目标 |
FID ↓ |
| 后验均值 μ~t |
原始变分目标 |
13.22 |
| 噪声 ϵ |
原始变分目标 |
13.51 |
| 噪声 ϵ |
简化的无时间步权重 MSE |
3.17 |
在原始变分目标下,预测均值和预测噪声的结果接近;最好的效果来自噪声预测参数化与简化训练权重的组合。所以,本文的经验结论需要结合这两个选择一起理解。
作者也尝试直接学习反向分布的对角协方差,但在本文的实验设置中,训练稳定性和生成质量不如固定方差的方案。后来 DiT 中使用的方差学习,还涉及后续 Improved DDPM / ADM 的设计,不能直接当作这篇原始 DDPM 的默认做法。
渐进生成与压缩视角
除了最终生成效果,作者还观察了反向过程的中间状态。我们已经有了由 xt 估计干净图像的公式,因此可以在采样过程中持续观察 x^0 怎样变化。论文的可视化中,大尺度结构较早出现,细节随后逐步完善。
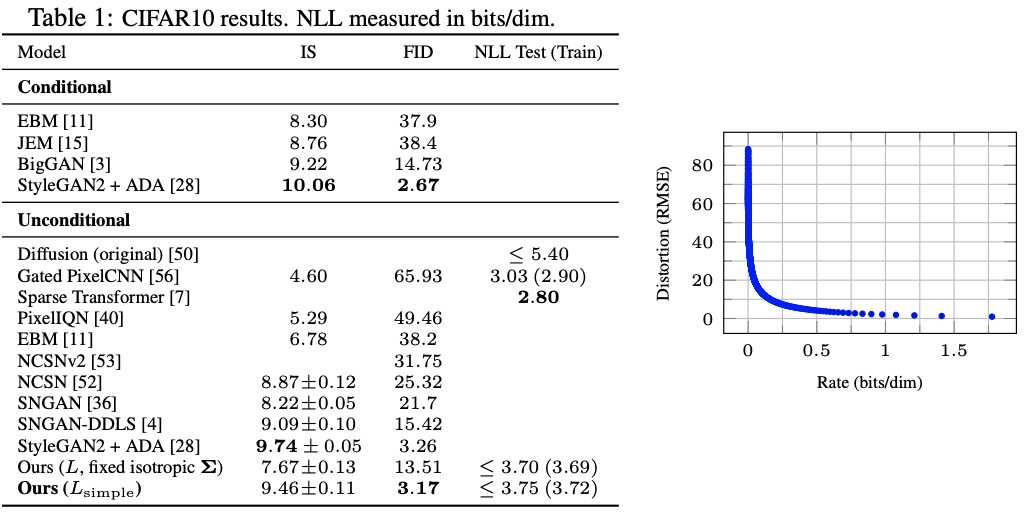
图来自作者项目页,展示图像生成指标与渐进有损压缩的分析。
从压缩角度看,反向过程也可以被理解为逐步传递图像信息:已有部分信息时,就能先得到一份粗略估计;继续接收信息后,重建误差进一步下降。论文通过变分目标中的 KL 项分析信息代价,并用 x^0 与真实图像之间的 RMSE 衡量失真,发现低码率区域的误差下降很快。
这帮助解释了前面那个现象:一些对精确编码仍然有成本的微小差异,未必会显著改变视觉效果。因此,直接优化完整似然与优先获得好看的样本,会产生不同的训练取舍。
作者还将两张真实图像分别加噪到同一个时间步,在两个中间状态之间做插值,再通过反向过程生成图像。随着插值所用的噪声水平改变,结果可以在保留较多原图信息与产生更大变化之间调整。这里使用的中间表示就是像素加噪状态 xt。
核心点和不足
值得关注
DDPM 将一个复杂的图像分布学习问题,组织成了一组有明确监督的去噪任务。前向过程的闭式表达让训练输入可以直接生成;已知原图时的高斯后验,让反向分布的训练目标可以计算;噪声预测参数化则将这个目标进一步连接到简单的 MSE。
这条链的价值在于,概率模型、训练目标和最终采样过程能够对应起来。网络预测的噪声有明确用途,采样公式中的系数也来自前向过程和反向参数化。
同时,本文将反向分布的具体主干与扩散目标分开了。原始模型使用 U-Net,后来的 DiT 用 Transformer 处理带噪输入,但仍然可以采用噪声预测这类目标。理解这篇文章后,再读这些工作时,就能分别追踪:生成对象如何表示,主干怎样处理它,以及预测结果怎样被采样器使用。
仍然存在的问题
首先,原始采样需要依次运行 1000 个反向步骤,每一步都要调用神经网络。训练时只抽一个时间步的高效做法,并不能直接消除生成时的串行计算,这让采样加速成为后续工作的一个重要问题。
其次,本文直接在像素空间处理图像。分辨率增加时,每一步网络处理的空间尺寸也会增加,多步去噪的计算成本因此更加明显。后来 Latent Diffusion 将扩散搬到压缩后的特征空间,就是沿着计算表示继续改进的一条路线。
另外,本文主要验证无条件生成。如何将类别、文本或空间约束有效接入去噪过程,需要额外的条件建模;这也与 DiT 笔记中讨论的条件注入和 CFG 等后续设计形成联系。
总结
DDPM 的主要过程可以归纳为:
- 用固定的高斯前向过程,将真实图像变成不同噪声水平的训练样本;
- 根据变分目标与高斯后验,把反向均值的学习改写成噪声预测,并采用简化 MSE 训练;
- 从高斯噪声出发,利用预测噪声计算每一步的反向均值,逐步采样得到图像。
其核心是通过一个容易计算的破坏过程,建立一套可以学习的生成过程。阅读时最值得真正理顺的,就是从 q(xt∣x0)、后验 q(xt−1∣xt,x0),到 μθ 的噪声参数化,再到训练与采样算法的这条关系。
接下来可以继续读 Improved DDPM,看看方差学习、训练权重和采样效率怎样改进;也可以读 DDIM,理解同类噪声预测模型怎样配合不同的采样过程。再回到 DiT,就可以更清楚地区分它沿用的扩散框架与重新设计的 Transformer 主干。
参考