论文阅读:Fine-Tuning Vision-Language-Action Models - Optimizing Speed and Success
引:Moo Jin Kim、Chelsea Finn 和 Percy Liang 在这篇文章中研究,怎样更有效地将已有的 Vision-Language-Action 模型微调到新机器人和新任务。作者以 OpenVLA 为基础,组合并行动作解码、action chunking、连续动作和 L1 回归,提出 OpenVLA-OFT;在双臂实验中又加入 FiLM,增强语言对视觉特征的影响。
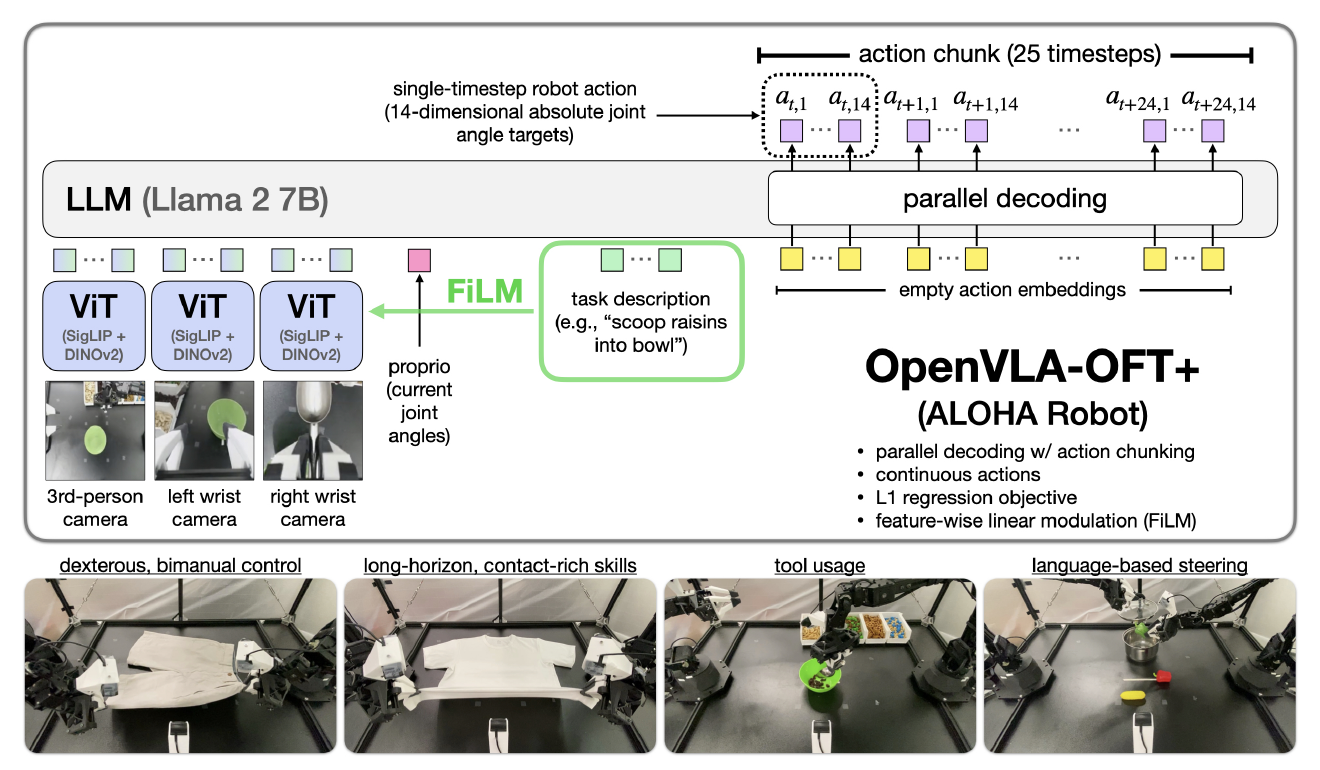
图为双臂 ALOHA 实验所用的 OpenVLA-OFT+:模型接收三路图像、机器人状态和语言,输出 25 个时间步的动作。图来自原论文 Fig. 1。
背景
VLA 可以理解为将视觉、语言与机器人动作接在一起的策略模型。例如,输入一张桌面图像和“把茄子放进锅里”,模型要根据当前场景产生机械臂动作;执行之后再观察环境,并继续决定后面的动作。
已有 VLA 在大规模机器人数据上预训练,能够理解一定的视觉和语言信息。但遇到新的机器人、新的动作空间或更快的控制频率时,通常仍需要用新任务的示范数据微调。论文研究的问题是:是否必须沿用预训练时的动作输出方式,才能有效利用预训练模型?
作者以 OpenVLA 为例。原始 OpenVLA 将单个时间步的七维动作离散为七个 token,再通过自回归方式一个一个预测。这个方式适合直接复用语言模型的 next-token 训练,但如果一段动作需要更多维度或更多时间步,推理时的串行步骤也会增加,对高频控制尤其不利。
作者把微调设计拆成三组选择:动作是逐个生成还是并行生成;一次预测一个动作还是一段 action chunk;动作保持离散 token,还是改为连续数值并选择相应的训练目标。本文的 OFT 是这些选择的组合,而不是重新训练一个全新的 VLA。
方法
原始 OpenVLA
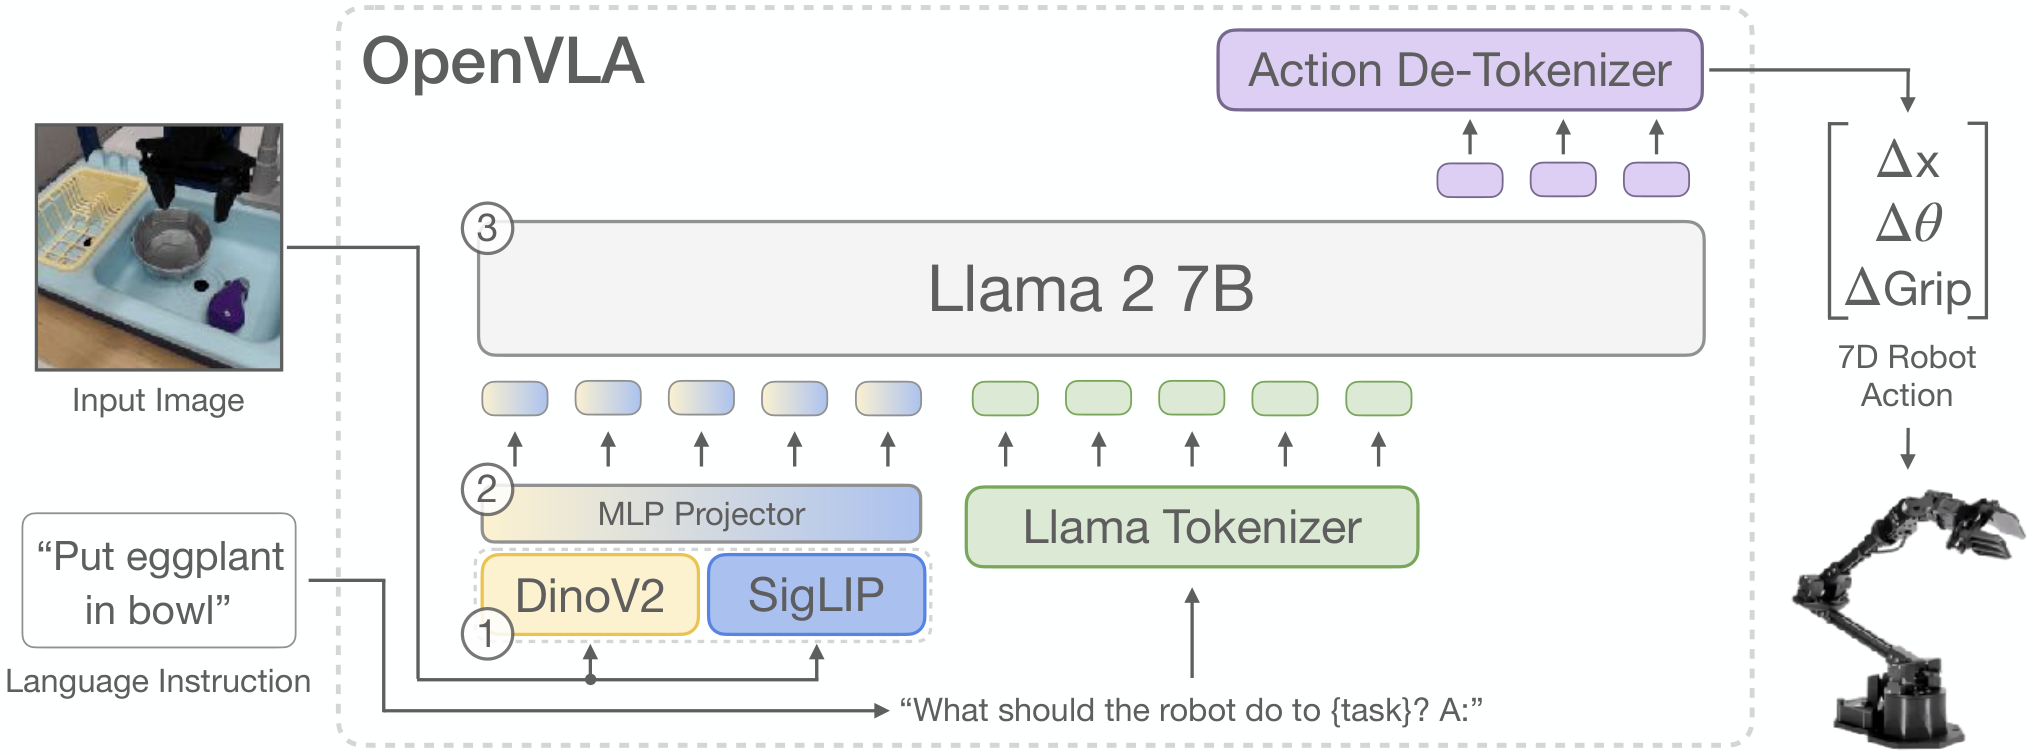
OpenVLA 由视觉编码器、将视觉特征映射到语言模型空间的 projector,以及 Llama 2 7B 主干组成。视觉部分融合 SigLIP 和 DINOv2 的特征;图像 token 与任务描述的文本 token 交给语言模型处理,再生成机器人动作。
在论文使用的原始单臂设定中,一个动作有 7 个维度:3 个位置变化量、3 个姿态变化量和 1 个夹爪控制量。每个归一化到 的维度被分成 256 个区间,变成一个离散 token。模型按顺序输出七个 token,并用 next-token 交叉熵训练。
例如,给定当前图像和任务,模型先预测第一个动作维度的 token,再把它作为上下文预测第二个,直到得到完整动作。若要预测未来 个时间步、每步 维动作,直接沿用这种逐 token 解码,就需要依次预测 个动作 token。
并行解码与 action chunk
作者首先修改动作解码方式。在训练时,原始模型接收右移的真实动作 token,并通过 causal mask 只能访问当前位置以前的内容;推理时则要把上一步的预测送回去生成下一个 token。
并行方案改用一组空的 action embeddings作为输出位置,它们靠位置编码区分;同时将 decoder 的因果注意力改为双向注意力。模型一次处理当前观测、语言及全部动作位置,再同时读出这些位置的预测。
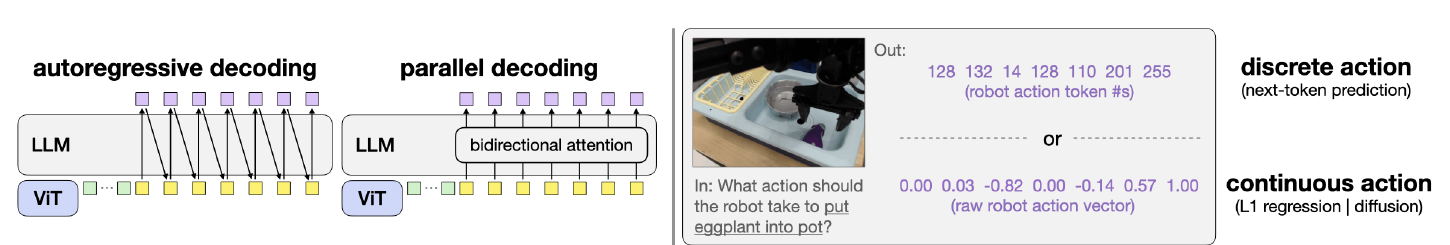
左侧对比逐 token 生成和并行生成,右侧对比离散动作与连续动作。图来自原论文 Fig. 2。
这样,一次前向不仅可以输出单个时间步的 个动作分量,还可以扩展到未来 个时间步,形成一个 action chunk。例如 、 时,模型一次输出 个标量,分别对应连续 8 个时间步的七维动作。自回归方案需要按顺序生成这 56 个动作 token,并行方案则在一次前向中处理这些动作位置。
生成整段动作后,机器人依次执行它们,再重新读取观测并预测下一段。论文的 LIBERO 实验使用 ,双臂 ALOHA 实验使用 ,都执行完整的 chunk 后再规划。这样的做法减少了模型调用次数,但一个 chunk 内没有重新查询策略,环境发生意外变化时也要等到下一次规划才能利用新观测。
连续动作与训练目标
原始 OpenVLA 用 256 个离散区间表示每个动作分量,这能直接沿用语言模型的 token 输出;但每个区间覆盖一个数值范围,可能丢失更细的动作精度。作者因此比较离散动作与连续动作两种表示。
在连续版本中,模型不再输出动作 token 的分类概率,而是将 decoder 最后一层的动作位置特征交给 MLP action head,直接得到连续动作值。论文实现了两种训练目标:
- L1 regression:让预测动作与示范动作之间的平均绝对误差尽量小。输出一整段动作只需要一次前向预测。
- Diffusion:对示范动作加噪,训练模型预测噪声;生成时从噪声逐步去噪,得到连续动作。论文的主要实现使用 50 个去噪步骤。
L1 回归可以写成:
这里 是示范数据中第 个时间步、第 个动作分量, 是对应预测。这个式子说明监督怎样作用于一个 chunk:模型要同时拟合每个时间步的每个动作分量。
Diffusion 可以表示更复杂的动作分布,但多次去噪增加推理延迟;L1 只需一次预测,但对同一个状态下存在多种合理动作策略的情况,表示能力也可能受限。作者用实验比较了两者,而不是预先假定更复杂的目标一定更好。
多模态输入
新的机器人不一定只有一个相机,也可能提供关节角度或夹爪状态等 proprioception(本体状态)。作者在微调时扩展输入:多路图像通过共享的视觉编码器及 projector 得到图像 token;低维机器人状态经过独立的投影网络,变成语言模型维度的一个额外 token。
随后,图像 token、本体状态 token 和语言 token 沿序列维拼接。它们与空的动作位置一起进入 decoder,供模型在输出动作时访问。这里扩展的是输入信息和动作头,视觉语言主干的预训练仍然提供了初始化。
例如,从单个第三人称相机增加腕部相机后,LIBERO 设置中进入 decoder 的视觉 patch token 从 256 增加到 512。双臂 ALOHA 使用一个外部相机和两个腕部相机,并输入 14 维关节状态;动作也改为双臂的 14 维目标关节角度。
FiLM
在一些真实机器人任务中,同一场景里有多种食材,指令中的词决定了应该抓取哪一种。作者发现,多视角输入可能带来与任务无关的视觉相关性,模型有时会依赖场景外观而忽略语言。因此,双臂实验在 OFT 基础上加入 FiLM(Feature-wise Linear Modulation),称为 OpenVLA-OFT+。
作者先对任务描述的语言 embedding 求平均,再用投影层得到缩放向量 和平移向量 ,调节视觉特征 :
每个向量元素对应视觉 Transformer 隐藏维度上的一个特征,对所有空间 patch 广播。同一个维度在所有位置采用相同的条件缩放和平移;不同 block 则有自己的投影参数。论文在 SigLIP 和 DINOv2 的视觉 Transformer 中都加入 FiLM,位置是在每个 block 的 self-attention 之后、前馈层之前。
这里也可以联系 DiT 中的 adaLN:二者都让条件生成逐特征的缩放和平移。但 OFT+ 这里调节的是视觉编码器的特征,条件是任务语言;DiT 的 adaLN 则用于扩散 Transformer 的归一化特征和残差结构。FiLM 的 让初始化接近零的调制从接近原视觉特征的状态开始。
实验
LIBERO 设置
作者在 LIBERO 的 Spatial、Object、Goal、Long 四组仿真任务上评估,每组 10 个任务、共 500 条专家示范;每组分别微调一个策略。OpenVLA 实验采用 LoRA 微调,并报告任务成功率。以下比较先使用同样的第三人称图像和语言输入:
| 微调方式 | Spatial | Object | Goal | Long | 平均成功率 ↑ |
|---|---|---|---|---|---|
| 原始 OpenVLA | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| 并行解码 + action chunk | 91.3 | 92.7 | 90.5 | 86.5 | 90.2 |
| 再改为连续动作 + diffusion | 96.9 | 98.1 | 95.5 | 91.1 | 95.4 |
| 再改为连续动作 + L1(OFT) | 96.2 | 98.3 | 96.2 | 90.7 | 95.3 |
这组结果显示,加入并行解码和 chunk 后,平均成功率从 76.5% 到 90.2%,其中 Long 任务的变化尤其明显。再改为连续动作时,两种目标都提高到约 95%;在这组设置中,L1 与 diffusion 的成功率接近。
论文还加入腕部相机和机器人状态,并在其修改过的训练数据设置下得到 97.1% 的平均成功率。这个结果使用了额外输入,不能把从 76.5% 到 97.1% 的全部差异单独归因于动作解码方式。
推理效率
论文在 A100 上对七维动作进行 100 次查询,分别测量一次生成一个动作或一个 chunk 的延迟,以及每秒生成的动作时间步数量:
| 微调方式 | 动作吞吐量(Hz)↑ | 单次延迟(秒)↓ |
|---|---|---|
| 原始 OpenVLA,单步动作 | 4.2 | 0.2396 |
| 并行解码,单步动作 | 15.9 | 0.0629 |
| 并行解码 + 8 步 chunk | 108.8 | 0.0735 |
| 并行 + 8 步 chunk + 连续 L1 | 109.7 | 0.0729 |
| 并行 + 8 步 chunk + diffusion(50 步) | 4.2 | 1.9070 |
这里的 26 倍来自 ,指的是动作时间步吞吐量。它包含一次预测 8 步动作的收益;单次预测延迟从 0.2396 秒降到 0.0729 秒,约降低到原来的三分之一,并不是缩短 26 倍。
50 步 diffusion 虽然同样并行输出一个动作 chunk,但去噪过程仍有多次迭代,因而单次等待时间较长。作者也测试减少去噪步数:5 步时吞吐量为 35.1 Hz、Long 成功率为 90.0%;1 步时吞吐量为 109.4 Hz,但 Long 成功率降到 0%。这个实验展示了采样计算与策略质量之间的取舍。
ALOHA 双臂实验
真实机器人实验使用 ALOHA 双臂平台,控制频率为 25 Hz。四类任务分别是折短裤、折衬衫、按指令舀指定食材,以及按指令将指定物体放入锅中。训练示范数量依任务而异,从 20 到 300 条不等,模型分别针对各任务微调。
这里比较的是加入 FiLM 的 OpenVLA-OFT+,以及微调的 、RDT-1B 和从头训练的 ACT、Diffusion Policy。作者使用任务分步完成度作为评分,因此图中的分数不完全等同于“整项任务成功或失败”的二元成功率。论文报告 OFT+ 在平均任务表现上最好。
在两个需要从三个候选物体中按语言选择目标的任务上,移除 FiLM 后,选择正确目标的成功率都降到约 33%,接近随机选择。这个现象说明,在这些 ALOHA 任务中,语言条件进入视觉特征的方式很重要;作者也指出,LIBERO 中不加 FiLM 的策略已经有较好的语言遵循能力,因此结果不能直接推广为“所有 VLA 都必须使用 FiLM”。
ALOHA 的推理效率测试中,原始 OpenVLA 为 1.8 Hz,OFT+ 为 77.9 Hz;前者一次输出 1 步,后者一次输出 25 步,且两者的推理延迟分别为 0.543 秒和 0.321 秒。这里同样需要区分 chunk 带来的吞吐量与单次模型响应延迟。
核心点和不足
本文值得关注的是,作者没有只比较两个模型的最终表现,而是把 VLA 的微调拆成动作解码、输出表示和训练目标,逐项观察哪些选择会改变速度与成功率。对于 OpenVLA,并行解码与 action chunk 解决了逐 token 生成的串行开销,连续动作和 L1 head 则提供了一种简单的输出方式。
这也带来需要继续研究的问题。L1 回归对同一观测下存在多种合理动作的示范数据,可能无法像生成式策略那样表达多个模式;完整执行一个 chunk 后再观察,也可能降低对突发变化的响应速度。论文的主要结论来自特定微调任务和示范数据,作者也将这种方案是否适用于大规模预训练、以及不同任务下的语言 grounding 差异列为后续问题。
总结
OpenVLA-OFT 的流程可以归纳为:
- 对预训练 OpenVLA 进行微调,输入图像、语言和可选机器人状态;
- 用空动作位置和双向注意力并行输出一个未来动作 chunk;
- 用连续动作和 L1 回归训练,在需要增强语言条件的双臂任务中加入 FiLM。
论文展示的是一个重要的设计思路:预训练得到的视觉语言表示,可以与不同的动作输出方式重新组合。 后续阅读 OpenVLA 或其他 VLA 时,可以分别追踪它们的观测条件、动作表示、一次生成的时间范围,以及最终控制时何时重新读取环境。
参考
- 原论文:Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success,本文依据 arXiv v2,发表于 RSS 2025。
- 作者项目页和官方代码:包含实验视频与实现。
- 文中配图裁自原论文 Fig. 1–2。
- AI 协助生成初稿。