论文阅读:Nexus
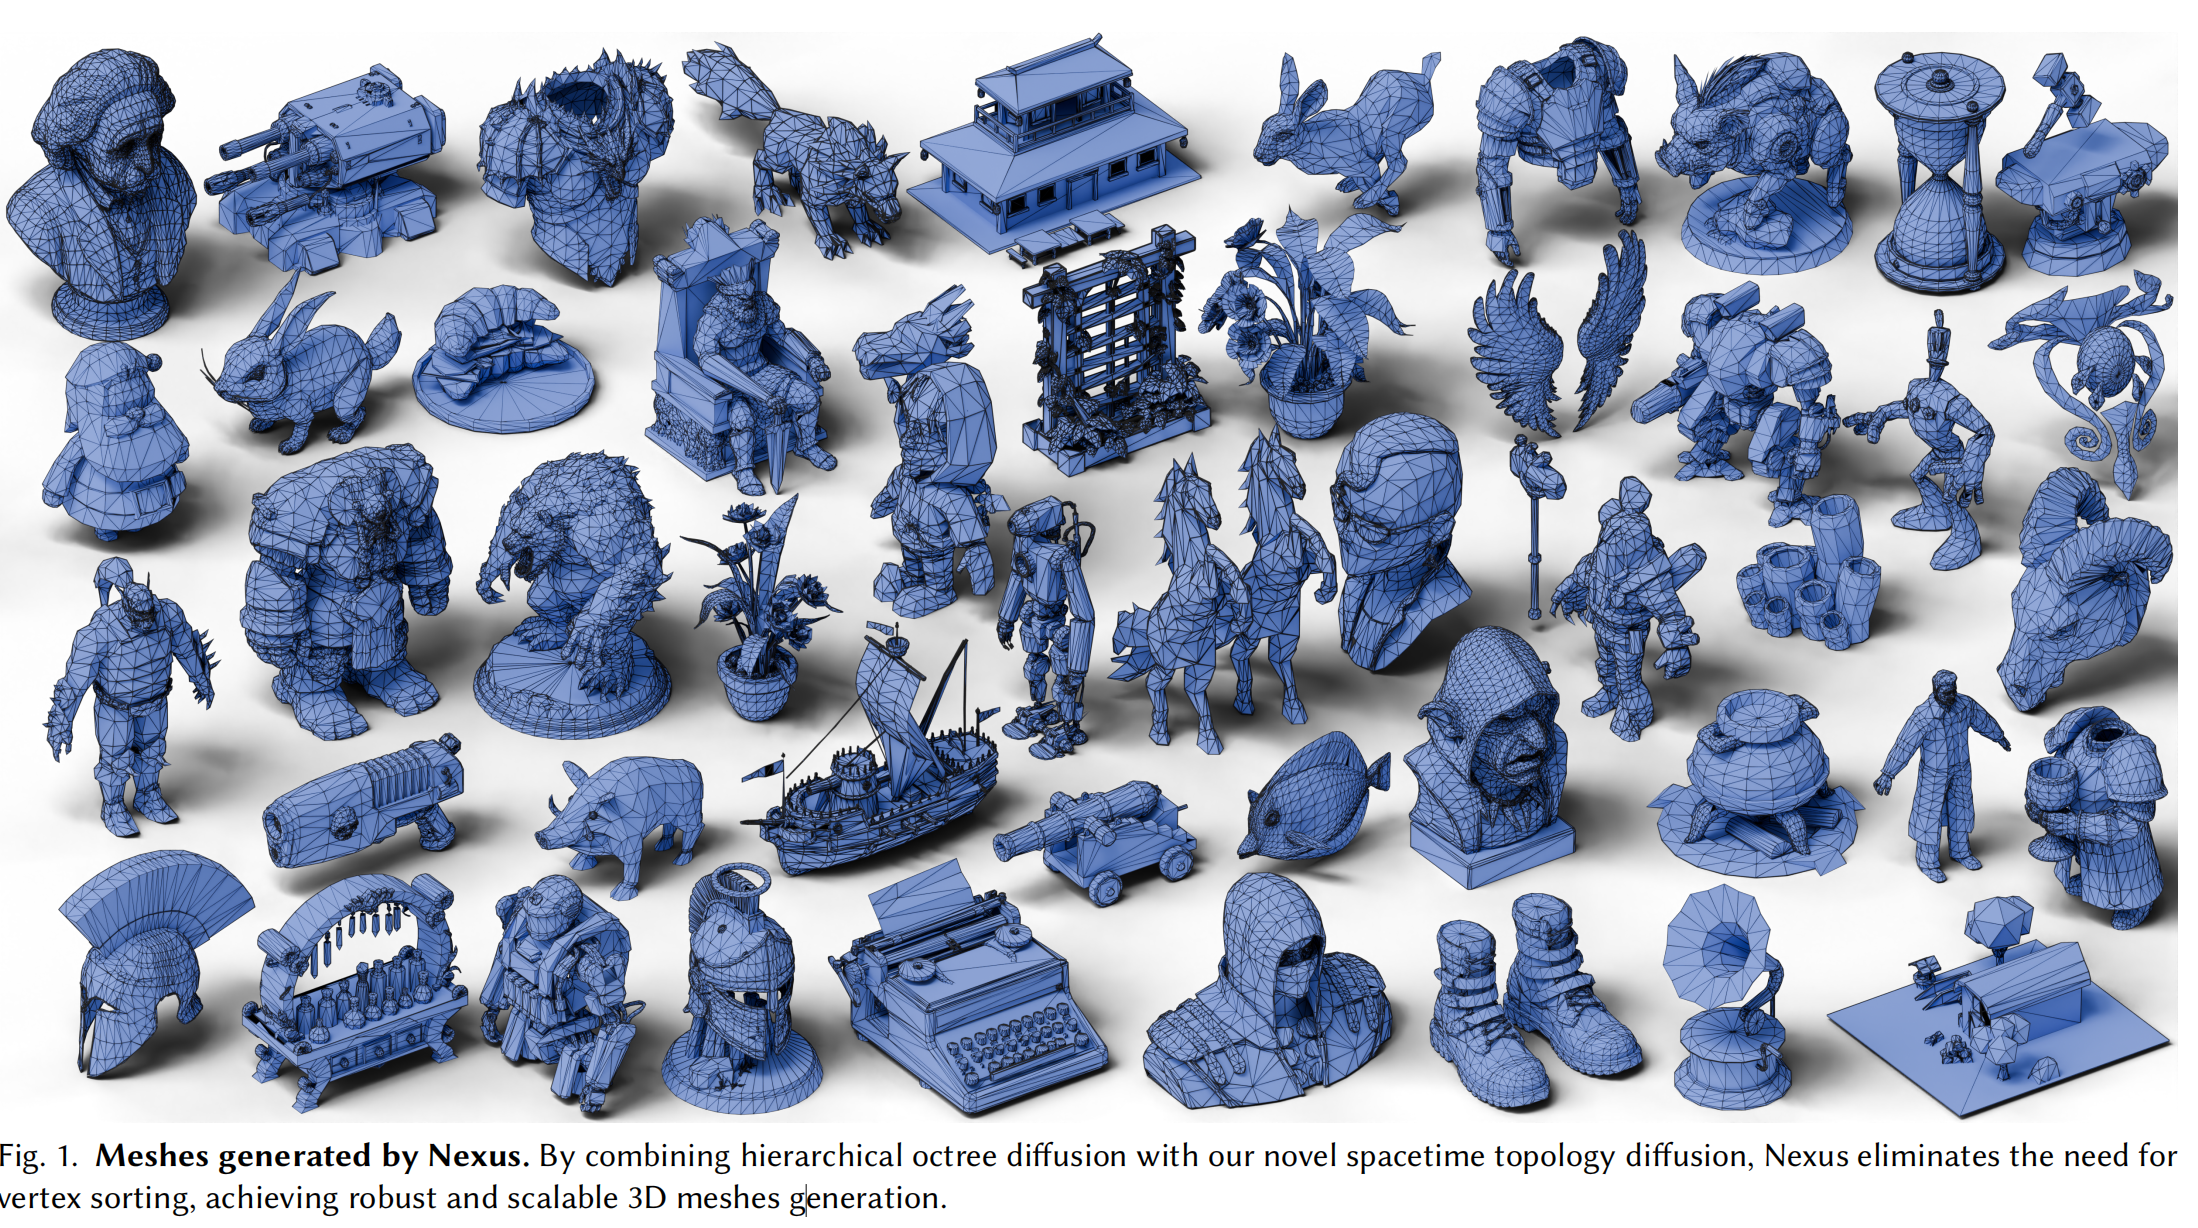
引:本文作者大多为VAST的科研人员,最大的亮点是提出了一种新的拓扑表示方式,从而避免了此前的方式——将Mesh表示为一串离散Token,并使用Transformer自回归生成——引入的自回归过程累计误差以及Mesh本身并不具备的顺序性质。
背景
现有艺术 mesh 生成方法通常把 mesh 表示成一串离散 token,然后用自回归 Transformer 一个 token 一个 token 地预测。很多研究重点放在:怎么把 mesh 压缩成更短的序列,从而让训练和推理更容易。
虽然这些方法效果不错,但有三个核心问题:
- 第一,mesh 越复杂,序列越长,生成一个 mesh 需要很多步自回归预测,所以推理可能很慢。
- 第二,自回归过程容易误差累积:前面某些 token 一旦错了,后面的 mesh 序列可能就全乱了。
- 此外,mesh 本身其实没有天然顺序,不应该被强行当作一个线性序列;它更像图像、点云一样,应该作为整体来建模。
已有一些基于 diffusion 的方法尝试直接处理三角面或 latent,但是它们在处理变长token序列的问题上效率始终有限,因此拓展性有限。
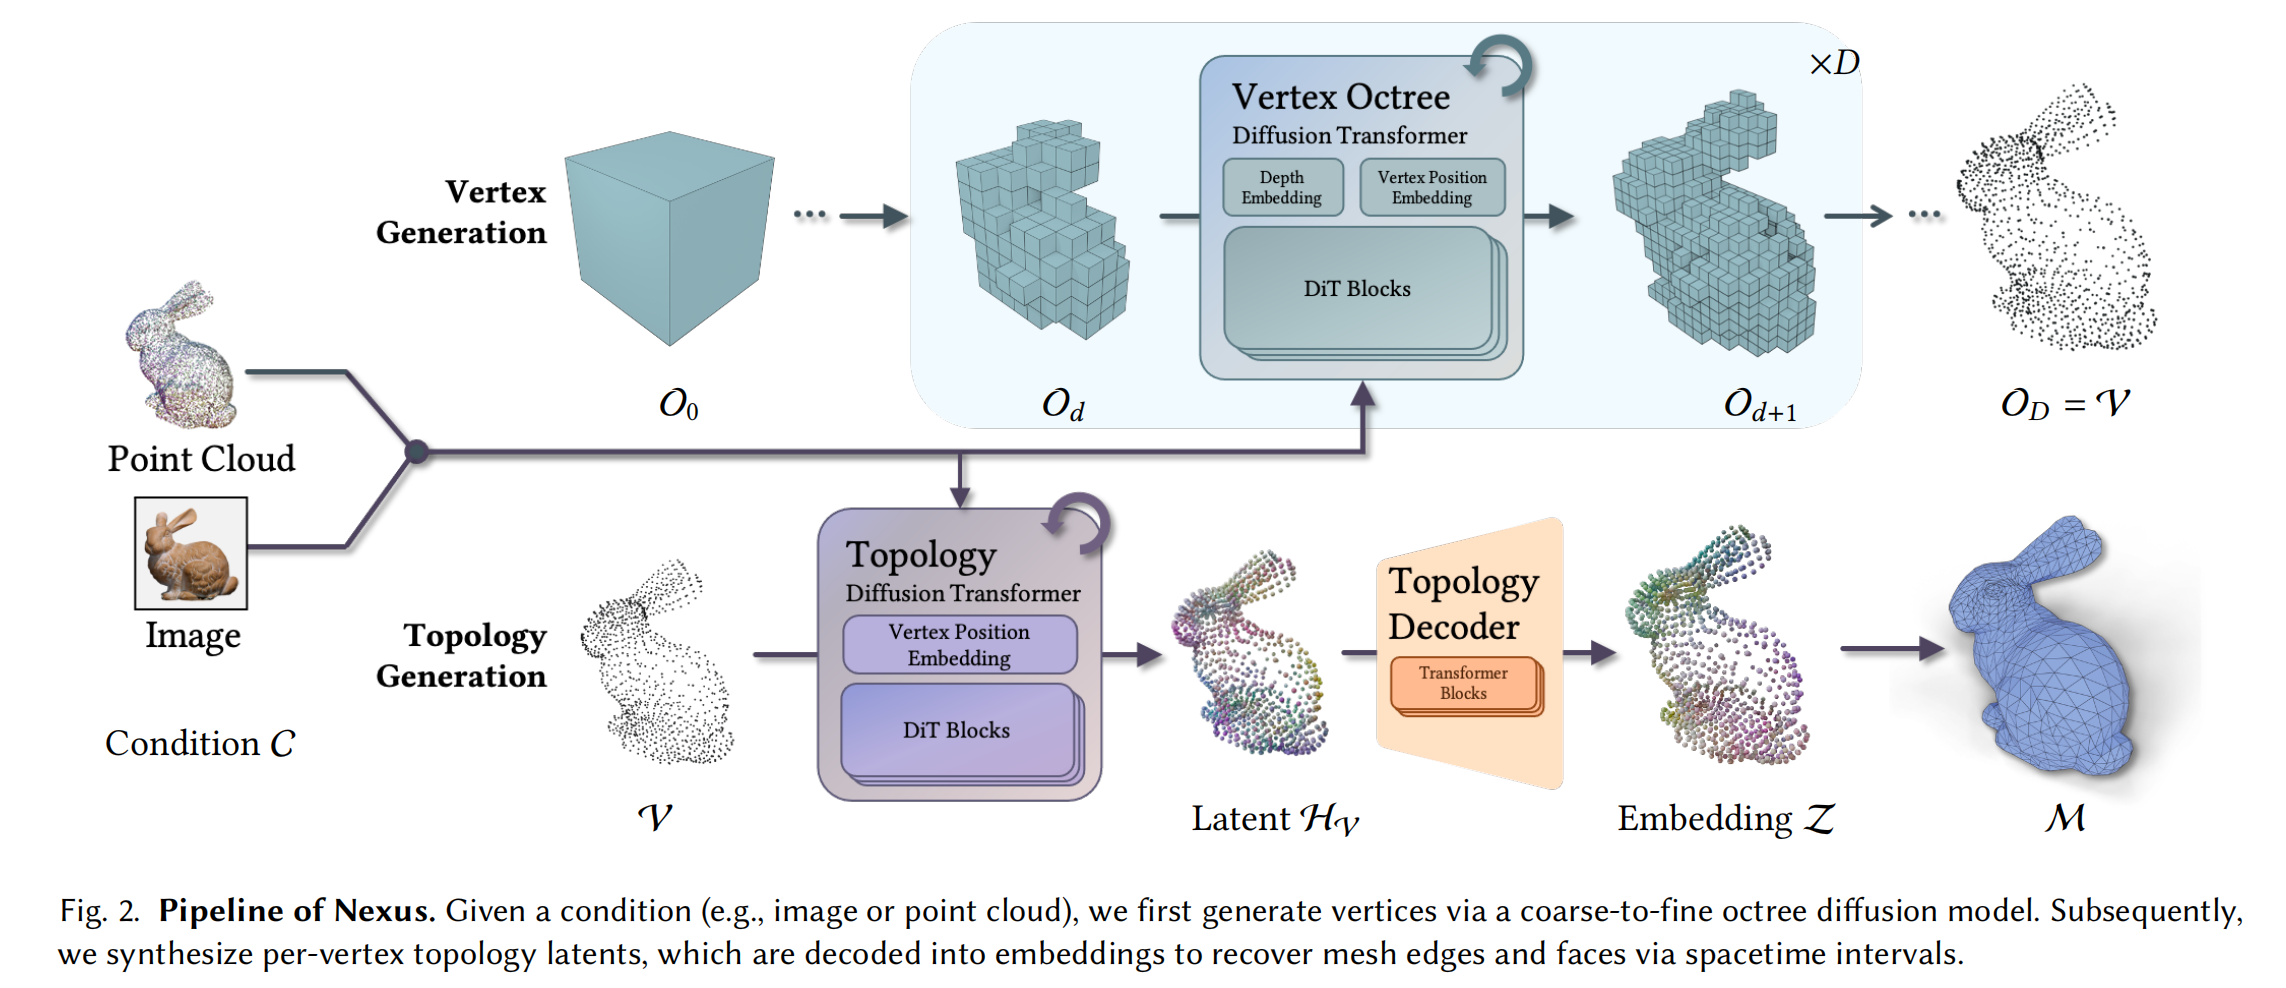
为了解决这个问题,作者提出 Nexus,这是一个同时用 diffusion 生成几何和拓扑的 mesh 生成框架。具体贡献总结如下:
- 提出 Nexus,一个完全基于 diffusion 的 mesh 生成框架,不需要排序,也避免了自回归序列化瓶颈。
- 设计了分层八叉树 diffusion,用 coarse-to-fine 的方式高效生成顶点结构。
- 提出 Spacetime Interval,把拓扑编码成每顶点特征,并通过 topology autoencoder 得到连续 latent,使 topology diffusion 成为可能。
- 在大规模数据集上展示了较好的生成效果,可以生成复杂、任意拓扑的 mesh,同时避免序列模型常见的误差累积。
方法
Nexus是一个用于在输入条件 下生成三角网格 的生成框架。这里的条件 可以是点云,也可以是图像。
如果把一个 mesh 记作,其中 表示顶点(Vertex)集合, 表示面集合。那么Nexus 要建模的就是一种条件概率。基本思想可以表达为以下的式子:
也就是说,这个生成过程是两阶段的,第一阶段用点云/图像条件来生成顶点集合,第二阶段在顶点集合的基础上,根据条件生成拓扑连接,也就是形成面。
顶点生成
Nexus 把顶点集合 表示成八叉树结构 :
我们可以想象一个立方体,它可以被等分为8个小立方体,而每个小立方体又可以被等分为8个更小的立方体……这样无穷分下去,总有一个时刻能做到让所有顶点都身处不同的小立方体。而这个分裂过程我们可以用一个八叉树来表示,假设树的深度是,所以我们就可以用一个 bit的坐标来描述一个顶点,且每个顶点都是八叉树中一片叶子。
而我们的目标就是先生成这样一个物体的顶点集合。文中提到这个生成过程是一种“Coarse-to-Fine”的过程,也就是从最外层的尺度不断细分,直到达到规定的最大深度。我们用 表示深度 的八叉树节点分布情况,生成过程就可以写成一种条件概率:
所以每一层八叉树的生成都依赖上一层的情况和输入条件。
训练
作者选择用一个统一网络来建模所有深度上的生成,它可以预测每个存在顶点的父节点(Occupied Parent)的8个子节点的顶点分布情况(Occupancy)。
在这样的一个八叉树中,每个节点的取值可以是0或1,1表示节点上存在一个顶点,0表示不存在。为了将这样的离散标识值放到连续生成模型里,作者将二值目标当成两个实数,然后使用flow matching来训练,即模型预测数据从带噪状态向正确答案的演变方向。自然地,针对这样的任务,主干网络被设计为多层的DiT,它接受一个8维的Occupancy pattern,对其embedding后当成token来处理。举个例子:某时刻我们已经预测出八叉树某层一个节点中有顶点,然后我们假设它的8个子节点的值分布是[1, 0, 0, 1, 0, 0, 0, 1],这个向量会经过线性层被映射到高维,再加上位置编码(3D RoPE)和深度编码(这个编码可学习),成为最终被处理的token。
而另一方面,输入条件会通过编码以交叉注意力的方式注入降噪网络。如果是点云条件,就使用一个和DiT一同训练的VecSet Encoder;如果是图像条件,就使用预训练的DINOv3。
推理
推理时,模型按 Coarse-to-Fine 的方式生成顶点。开始只有一个根节点,之后每一层里模型都从上一层预测出来的里找出含顶点的nodes,然后用训练好的diffusion模型预测,一直重复到最深层D。最后,最深层里所有有顶点的节点,其对应的小立方体的中心点就作为这个顶点的坐标。
拓扑生成
为了生成 mesh topology,作者设计了一个 topology AE,并训练一个在顶点条件下工作的 diffusion 模型。作者将边拓扑和面拓扑分开建模,先花费的时间恢复edge,再在edge graph上枚举三角形。这种方法的计算量比直接恢复一个一个face(的复杂度)要少。
在这个阶段,模型学习每个顶点的 embedding,用它判断两个顶点之间是否有边、三个顶点之间是否组成一个面。设每个顶点都有一个 embedding ,我们通过各顶点在这个embedding空间的分布情况,先判断由点如何连成边,然后判断不同边如何组成三角形。
整体的拓扑生成,是本文贡献较大的一个部分。而这部分的精华就在于判断边/面拓扑的距离度量:Spacetime Interval。下文详细介绍。
边拓扑 Edge Topology
衡量两个顶点Embedding的距离,最朴素的方法是使用欧氏距离度量,或者使用余弦相似度,如果这样的度量值接近某个阈值,就判断点和之间存在边。
但是本文用的是SpaceMesh提出的Spacetime Distance,为什么呢?作者认为欧氏度量下邻近关系倾向于在相邻的单位间传递(原文言“transitive proximity”),举例说,如果a和b邻近,而b和c邻近,那么a和c二者的度量值必然不超过2倍的用来判断邻近的阈值。但是在复杂的拓扑中连接与邻近并不存在必然的联系:假设三点在欧式空间的Embedding上相互邻近,但是实际上a与b之间存在连接,b与c存在连接,而a与c之间不存在连接。此时由于欧氏距离的这种“传递式邻近”,三者会被拉到一起,a与c的度量很可能会小于判断连接的阈值,从而很容易被认为是“有连接关系”。所以要使用一种能够表达这种情况的度量,Spacetime Intervals就是作者认为可以胜任的度量,并且它在SpaceMesh中被证明在表达这样的复杂关系中比欧氏距离相比收敛快得多。本文中作者也通过贴出采用不同Metrics进行预测的实验结果来证明了Spacetime Intervals在预测准确率上的优越性。
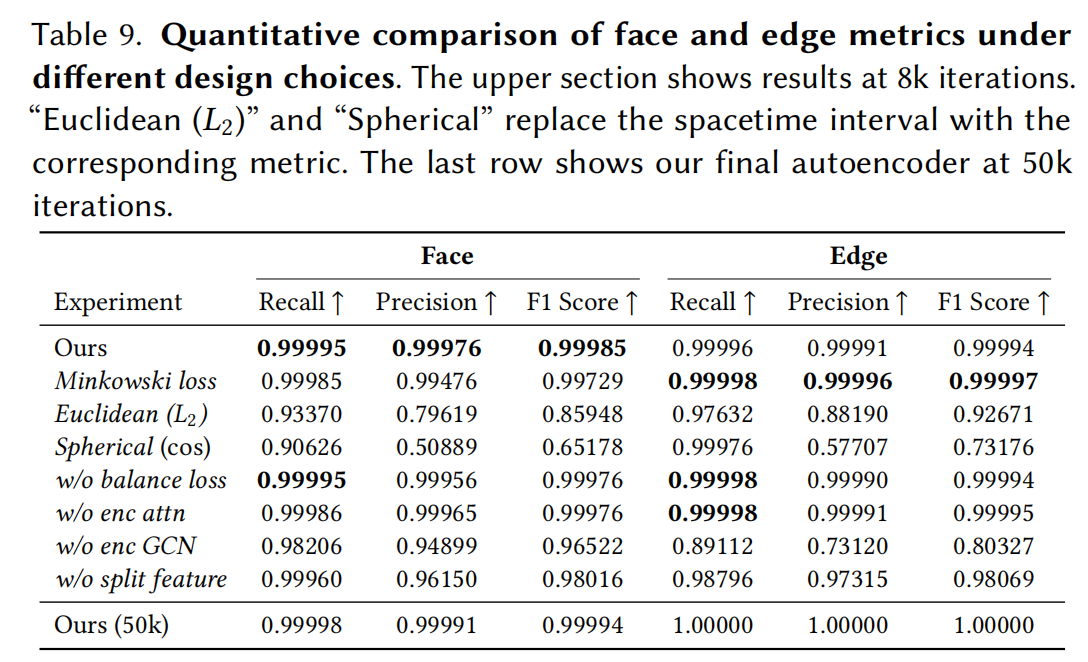
所以我们下面重点介绍一下Spacetime Intervals相关的知识。
正定度量 Positive Definite Metric
正定度量必须满足以下两个特征:
- (非负性)
- (在非负性的基础上,满足这一点,才算是具有正定性;否则只能是半正定)
欧式度量显然是一种满足非负性的度量,而且还是一种正定度量。
不定度量 Indefinite Metric
与正定度量相反,不定度量(Indefinite Metric)显然就是不满足非负性公理的内积或度量,也就是度量的取值可能小于0。下文所说的时空距离,就是一种不定度量。
1st Order Spacetime Interval
简单地说,我们的每个顶点的embedding维度被分为两部分,一部分是spatial分量,一部分是temporal分量。在算两个顶点之间的“距离”的时候,我们通过这样一种不定度量来划分顶点间是否存在边:如果这个度量小于等于0,二者之间无连接(无边);如果大于0,说明二者间存在一条边。
至于为什么它能解决上文提到的“传递性难题”,读者可以自己设置一个小case来印证,此处不赘述。总之原理就是多了一个轴的自由度,所以求解这样的连接关系也更方便。而这个Spacetime Distance在本文被作者称为1st Order Spacetime Intervals,为了和后面求解面的度量(2nd Order Spacetime)统一,下图是对应的图示。我们一会会继续介绍二阶量。
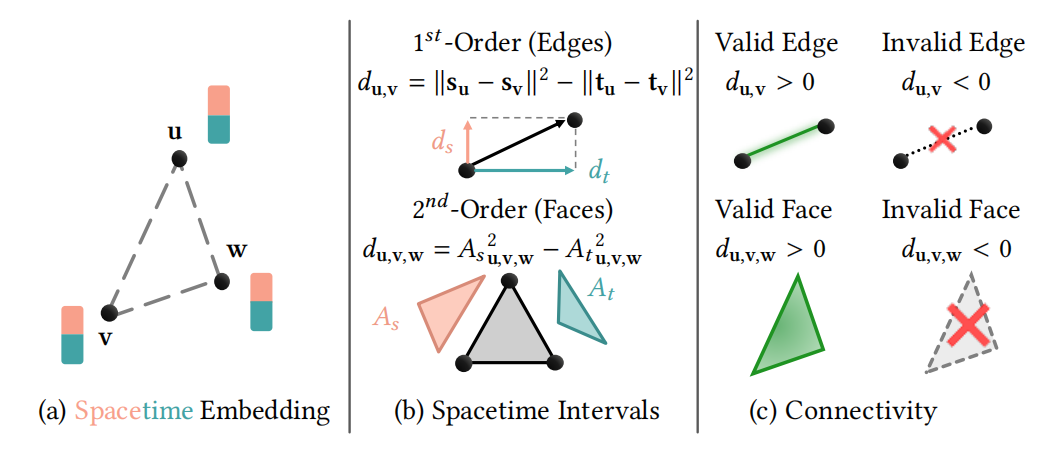
面拓扑 Face Topology
在面的表示和求解上,作者提出一种新的有关面连接性的度量,将一阶的时空间隔推广到二阶,用来判断三个顶点之间是否存在一个面。为什么有了边还不够呢?因为对于mesh来说,三条边围成的闭环,内部可以是一个面,也可以只是一个开口。 所以,仅仅恢复edge graph,并不能唯一确定face topology。
SpaceMesh本身也考虑了面的恢复,但是它的机制决定了它只能处理流形拓扑。而为了处理更一般的拓扑,Nexus选择另起炉灶,设置一个判断量来判断是否有(三角)面产生。
同胚
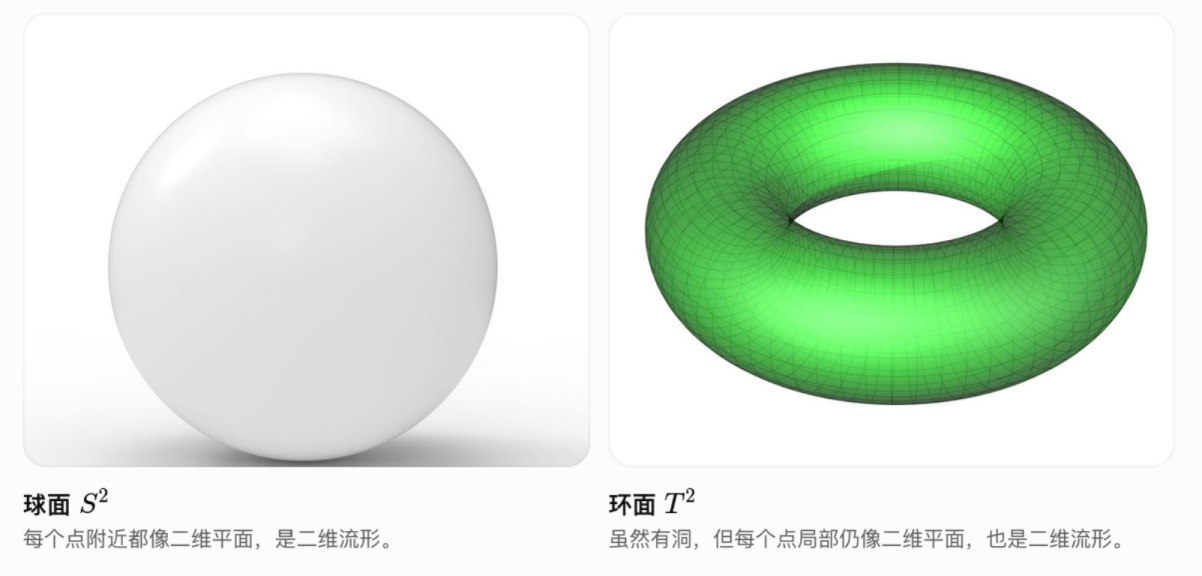
A与B同胚,即二者之间存在连续且逆映射也连续的双射关系。下图是一个典型的拓扑上的同胚的例子:
流形与非流形
对于流形的一个规范的数学定义对常人来说非常难懂,所以我们不会谈论它;我们可以通俗而粗暴地说明二维拓扑流形的一条重要性质,就是 无论你在曲面上选择哪个点,只要把这个点附近的区域放大,它在拓扑上都应该像一块普通的二维平面(也就是和一个二维平面同胚)。 而非流形显然就是不符合这个标准的拓扑。
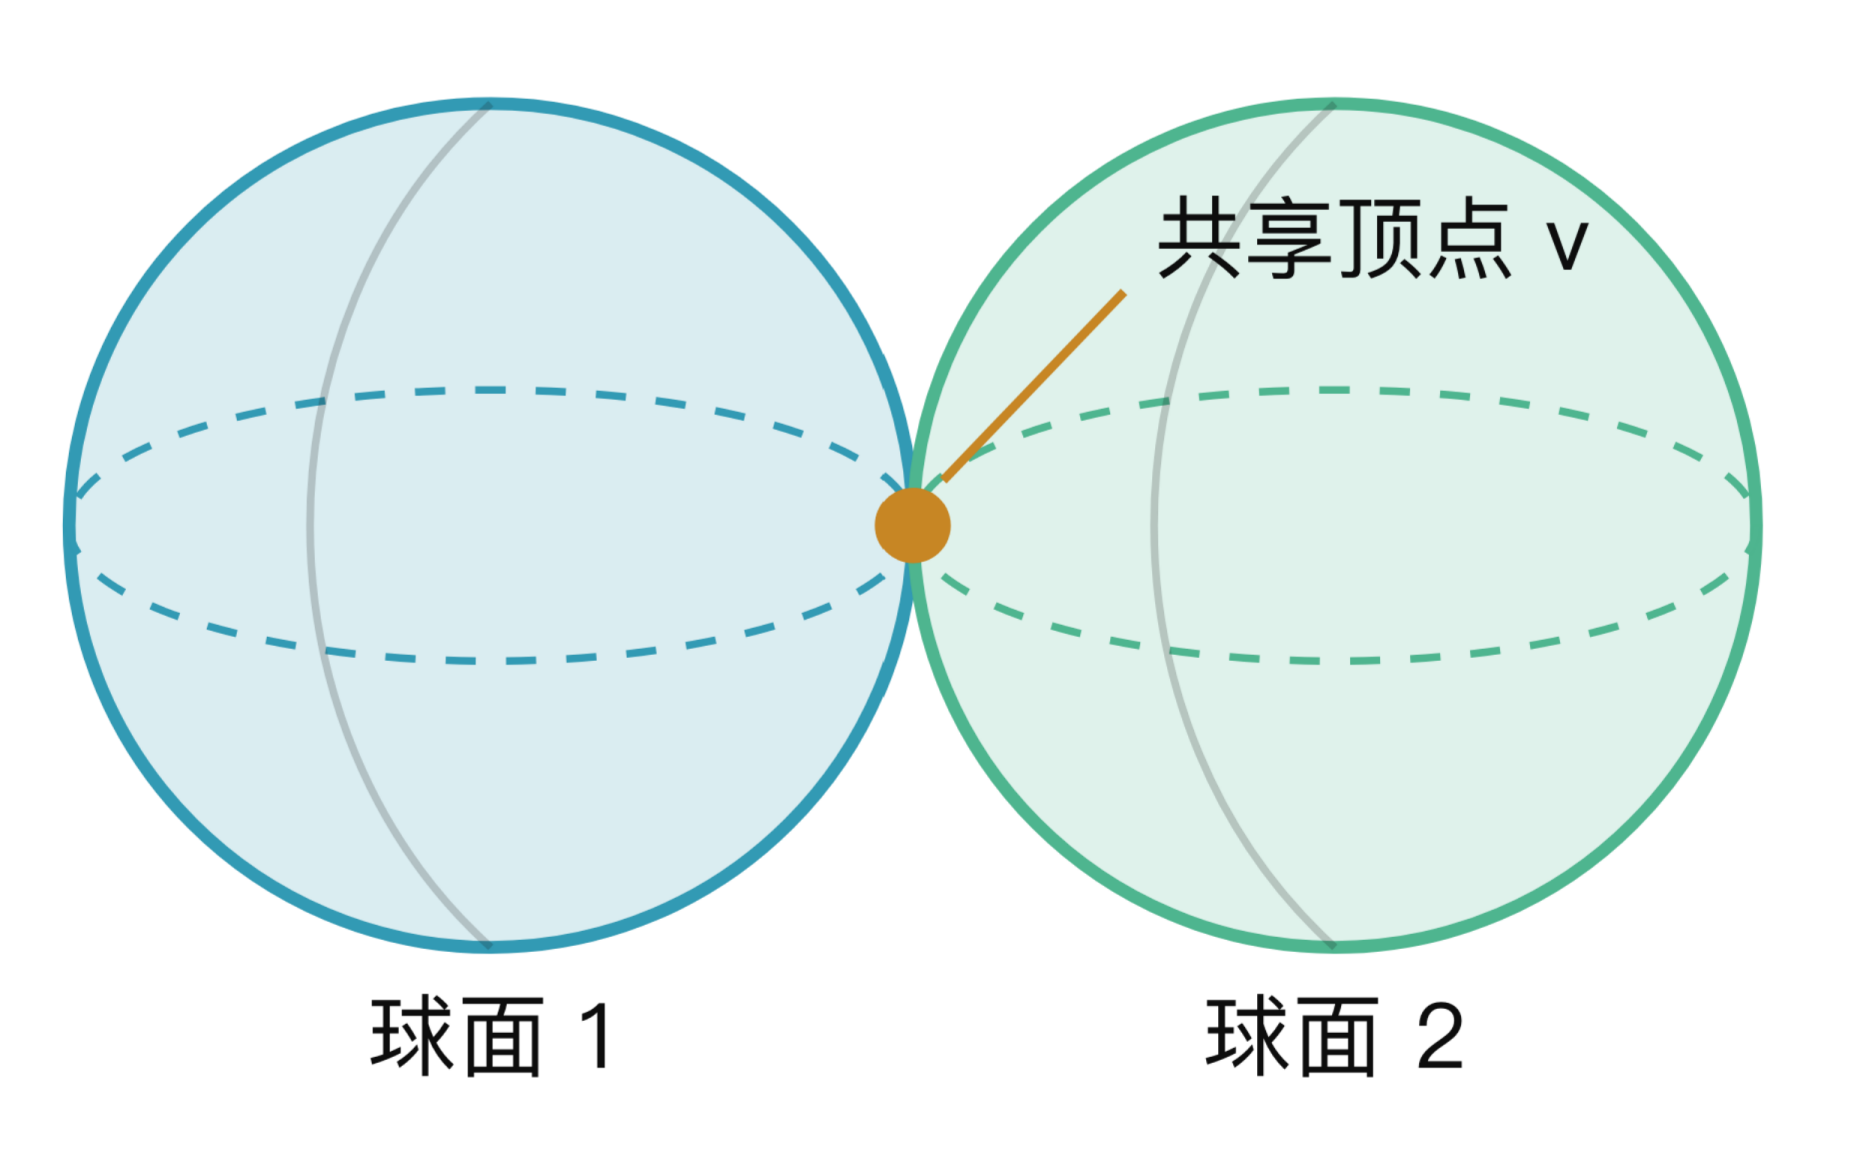
所以什么样的拓扑不符合所说的特征呢?典型的例子就是,如果一条边同时参与组成的面大于2个,那么这个边上的任意一点的邻域放大都不可能像一个二维平面。换言之,一条边同时参与组成的面不多于2个,是整个拓扑属于流形的必要条件。有一个特殊的例子可以否定它的充分性:两个相互接触的球面,只有一个共用顶点;虽然其中一条边同时参与组成的面只有2个,但是这个接触点的邻域并不与一个二维平面同胚,所以这个顶点就是非流形顶点,这个mesh也就不是二维流形。
半边 Half-edge
SpaceMesh的边/面设计是针对流形物体的,所以它将一条无向边转换成两个twin半边,例如从边无向边到两个有向边和。它规定这样的一个半边的数据结构如下:
2
3
4
origin: Vertex
twin: HalfEdge
next: HalfEdge举例而言,一个三角形,可以用三个半边来表示(半边、半边、半边),BC半边就是AB半边的
next;文章规定一个边由且只能由两个半边组成,这从根本上就杜绝了同一条半边拥有不同next的可能,从而也就死死地限定一个无向边拆分为两个半边后最多只能有两个邻近的半边,所以最多也只能参与两个面,因此就避免了许多非流形拓扑的情境。
2nd Order Spacetime Interval
我们先看欧氏空间中的情形。设三个顶点的embedding分别为,以为共同起点,令:
那么这两个向量所张成的三角形,其面积平方可以写成:
这是一个海伦公式的变形,读者可以自行证明其正确性。
接下来,沿用前面spatial和temporal两部分的划分,我们分别在两个子空间中计算三角形的面积,再作差:
这就是二阶时空间隔(2nd Order Spacetime Interval)。和一阶量一样,模型通过它的正负判断三个顶点之间是否存在一个面:时认为存在,否则不保留这个候选面。
所以,一阶量是在比较两个子空间里的长度平方,二阶量则是在比较两个子空间里的面积平方。形式上的对应关系很直观,不过这里的面积是embedding后在隐空间中计算出的“面积”,和真实的3D空间关系无关。这只是模型学出来的拓扑表示。
作者在实际实现中会将edge和face所使用的embedding分开,同一个顶点会有用于判断边和用于判断面的两套特征。这个设计让两种任务不必挤在同一个表示里,后面的消融实验也验证了这种划分的作用。
训练
现在我们有了判断边和面的规则,但是还有一个问题: 这些embedding从哪里来? 显然不能给每一个新物体都手动寻找一组特征。所以,作者先训练一个能重建拓扑的autoencoder,再训练一个能生成其latent的diffusion模型。
Topology Autoencoder
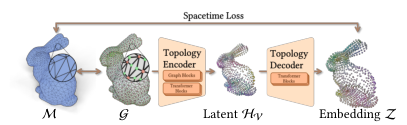
这一autoencoder的输入是一个完整的mesh,也就是顶点集合和面集合。作者将其转成一个图,但这个图并不是简单地“原mesh的顶点是节点、原mesh的边是连接”。它把顶点和面都当成图中的节点:顶点节点的初始特征是其坐标,面节点的初始特征是面的中心坐标;如果一个顶点属于某个面,就在二者之间建立连接。
这样做以后,面所包含的连接信息就能够通过图中的消息传递进入顶点特征。Encoder由交替排列的SAGEConv图卷积层与Transformer blocks组成,二者各有用处:
- 图卷积负责沿着已有的连接关系聚合局部信息,告诉模型哪些顶点、哪些面是相关的;
- Transformer负责全局的信息交换。尤其是当mesh存在互不相连的部件时,单靠图卷积无法让它们之间交流,而attention可以跨越这种连接上的隔离。
Encoder得到特征后,通过线性层预测和,再通过一个受KL散度约束的latent bottleneck:
最后,Decoder把这些latent转换为前面所说的时空embedding:
Decoder只处理顶点节点,主体是Transformer blocks,再用线性层输出每个顶点的embedding。此时我们就可以用一阶和二阶Spacetime Interval恢复连接,并和真实mesh中的边、面标签对比,以 Binary Cross Entropy(BCE) 作为重建的监督信号。
这里需要区分两个东西:是autoencoder中间的latent,后续diffusion要生成的是它;则是解码后的时空embedding,我们用它计算连接性。二者都是逐顶点的连续特征,但是所处的位置和用途不同。
稀疏标签与Loss Balancing
一个有个顶点的mesh,可能的顶点对有个,而真实存在的边通常只占其中很少一部分。对面的情况就更明显了:所有顶点三元组有个,但真实面仅占极少数。如果直接对所有样本的Loss求平均,就容易让大量“没有连接”的负样本主导训练。
作者因此采用了一种Loss Balancing策略。对于边,根据预测和真实标签,将顶点对分成TP、TN、FP、FN四组,先分别计算每组的平均BCE,再将四组结果平均。这四组分别对应预测正确的边、预测正确的无边关系、误判出来的边和漏掉的边。这样,大量正确的负样本就不会仅凭数量淹没其他组。
边的监督会覆盖全部顶点对;面的监督则覆盖全部真实面,再采样一部分不存在的面作为负样本,因为所有三元组实在太多了。对于面,作者同样采用平衡Loss的方式。
Topology Generative Model
训练好autoencoder之后,我们已经能把一个真实mesh的离散拓扑压缩成连续latent。不过这还只是重建,因为Encoder的输入中包含真实的面集合。要在没有真实拓扑时生成mesh,还需要再训练一个生成模型。
这一阶段,作者训练另一个DiT,在顶点集合和输入条件的约束下,生成逐顶点latent 。训练方式仍然是flow matching与velocity prediction;顶点的位置通过3D RoPE注入,点云或图像条件则和前面的顶点生成阶段一样,通过cross-attention注入。
所以,在这一阶段的生成模型看来,它的任务就是:给定一组顶点和输入条件,预测一组连续特征。至于这些特征最后如何变成边和面,由训练好的Decoder和Spacetime Interval来处理。原本离散的连接问题,就这样被转成了一个可以使用连续生成模型的问题。
推理
推理时不需要真实面集合,也不再使用Topology Encoder。我们可以把整个流程整理为:
- 用前面的八叉树diffusion生成顶点集合;
- 根据这些顶点和输入条件,用topology diffusion生成latent ;
- 用Topology Decoder得到时空embedding ;
- 对所有顶点对计算一阶时空间隔,恢复edge graph;
- 在这个图中寻找三条边闭合的三角形,也就是3-cycle,将它们作为候选面;
- 对候选面计算二阶时空间隔,只保留通过判断的面。
其中,先恢复边再筛选面,保证了被保留的面所依赖的边已经存在,避免边和面各自预测后出现相互矛盾的情况。
我们可以估算它的复杂度:恢复全部边仍然需要的点对判断;随后是在edge graph上枚举三角形,这样就不需要直接以的代价遍历全部顶点三元组,在稀疏图中可以显著减少需要检查的三元组。
实验
数据与基本设定
作者从Objaverse与ObjaverseXL中筛选出面数少于20,000的mesh,组成约100万个mesh的训练集。测试集使用未参与训练的500个Objaverse模型,以及900个面数少于4,000的Toys4K模型。
八叉树的最大深度设置为,因此每个坐标轴对应512个量化位置。点云条件在训练时使用从mesh表面采样的8,192个点及其法向,图像条件使用的渲染图像。顶点生成和拓扑生成的DiT各约20亿参数,Topology Autoencoder约1亿参数,其中latent的维度为64。
关于训练的资源需求,作者称该模型的训练使用了32张A100 GPU。
点云条件下的生成效果
这一部分主要使用两个指标: Chamfer Distance(CD) 衡量平均的表面重建误差, Hausdorff Distance(HD) 更关注最严重的表面偏差。二者都是越小越好;评估时会从mesh表面均匀采样50,000个点。
下面摘出原论文Table 3中的几种方法,方便对比:
| 方法 | Objaverse HD ↓ | Objaverse CD ↓ | Toys4K HD ↓ | Toys4K CD ↓ |
|---|---|---|---|---|
| TreeMeshGPT | 0.183 | 0.055 | 0.133 | 0.047 |
| BPT | 0.126 | 0.043 | 0.091 | 0.037 |
| FastMesh | 0.145 | 0.040 | 0.100 | 0.033 |
| Nexus | 0.104 | 0.031 | 0.071 | 0.027 |
从这个表中可以看到,Nexus在两个数据集的这两项指标上都更好。
作者还在Table 4中报告了边上的Chamfer Distance以及法向相关指标,其中Nexus的边几何误差较低,但法向指标并不是最好的,因为模型本身没有预测面的朝向,需要额外的方向修正。这一点出现在论文的局限性讨论中。
图像条件下的生成效果
图像条件的实验中,作者展示了与EdgeRunner、TRELLIS的对比。与TRELLIS相比,Nexus在原论文Table 8中的CD为0.0681,HD为0.2309;TRELLIS对应的数值为0.0802与0.2503。作者还使用了ULIP-Sim、UNI3D-Sim来衡量生成结果与输入图像的语义一致性。在论文展示的例子中,Nexus保留了更多尖锐结构和细节。
消融:Spacetime Interval是否有用?
前面已经放过不同Metrics的对比图,这里把最相关的数值列一下。下表摘自原论文Table 9,展示了8k步迭代训练后Topology Autoencoder的重建结果:
| 拓扑判断方式 | Face F1 ↑ | Edge F1 ↑ |
|---|---|---|
| Spacetime Interval | 0.99985 | 0.99994 |
| Euclidean | 0.85948 | 0.92671 |
| Spherical | 0.65178 | 0.73176 |
| Minkowski Interval | 0.99729 | 0.99997 |
首先,欧氏度量与球面度量明显不如其余两种方法,尤其是在面的重建这个任务上。而Minkowski Interval与本文用的时空距离效果相近:它直接在不定内积下计算一个统一的行列式,并不是本文采用的“两个子空间各算面积平方,再相减”。这个变体的边指标略高,但面指标更低。作者推测,分开计算可能有更好的数值稳定性;这仍然是作者给出的解释,并不是已经被严格证明的原因。
原论文也比较了去掉图卷积、去掉全局attention、让边与面共用embedding等设定。其中去掉图卷积带来的下降较大,这和前面解释的Encoder作用相符:已有拓扑需要通过连接关系被编码进去,只有坐标和全局attention还不够。
另外要注意,这里的F1是在已有mesh经过编码、解码之后算出的,是autoencoder的重建指标。即便重建F1接近1,也不代表完整diffusion生成流程已经能把每一个新mesh的拓扑都生成正确。
核心点和不足
值得关注
这篇文章回顾了传统的三维拓扑的表示方式,并给出了一种新选择。如果直接自回归地预测离散的面索引,生成模型就要面对变长的组合结构;而Nexus将连接关系用顶点的连续特征隐式表征,也就是用一个确定的规则来判断连接关系。这样,生成模型处理的是连续latent,但输出仍然是明确的顶点与面。Spacetime Interval的重要性也就在这里:它给出了一个相对简单、可以训练的“读出规则”,把表示学习和最终的离散拓扑连接起来。
与此同时,几何与拓扑分开生成,允许同一组顶点对应不同的连接方式。对有开口、多部件或者非流形结构的物体,这种建模思路不同于单纯从一个连续场中提取表面,有值得进一步研究的潜力。
仍然存在的问题
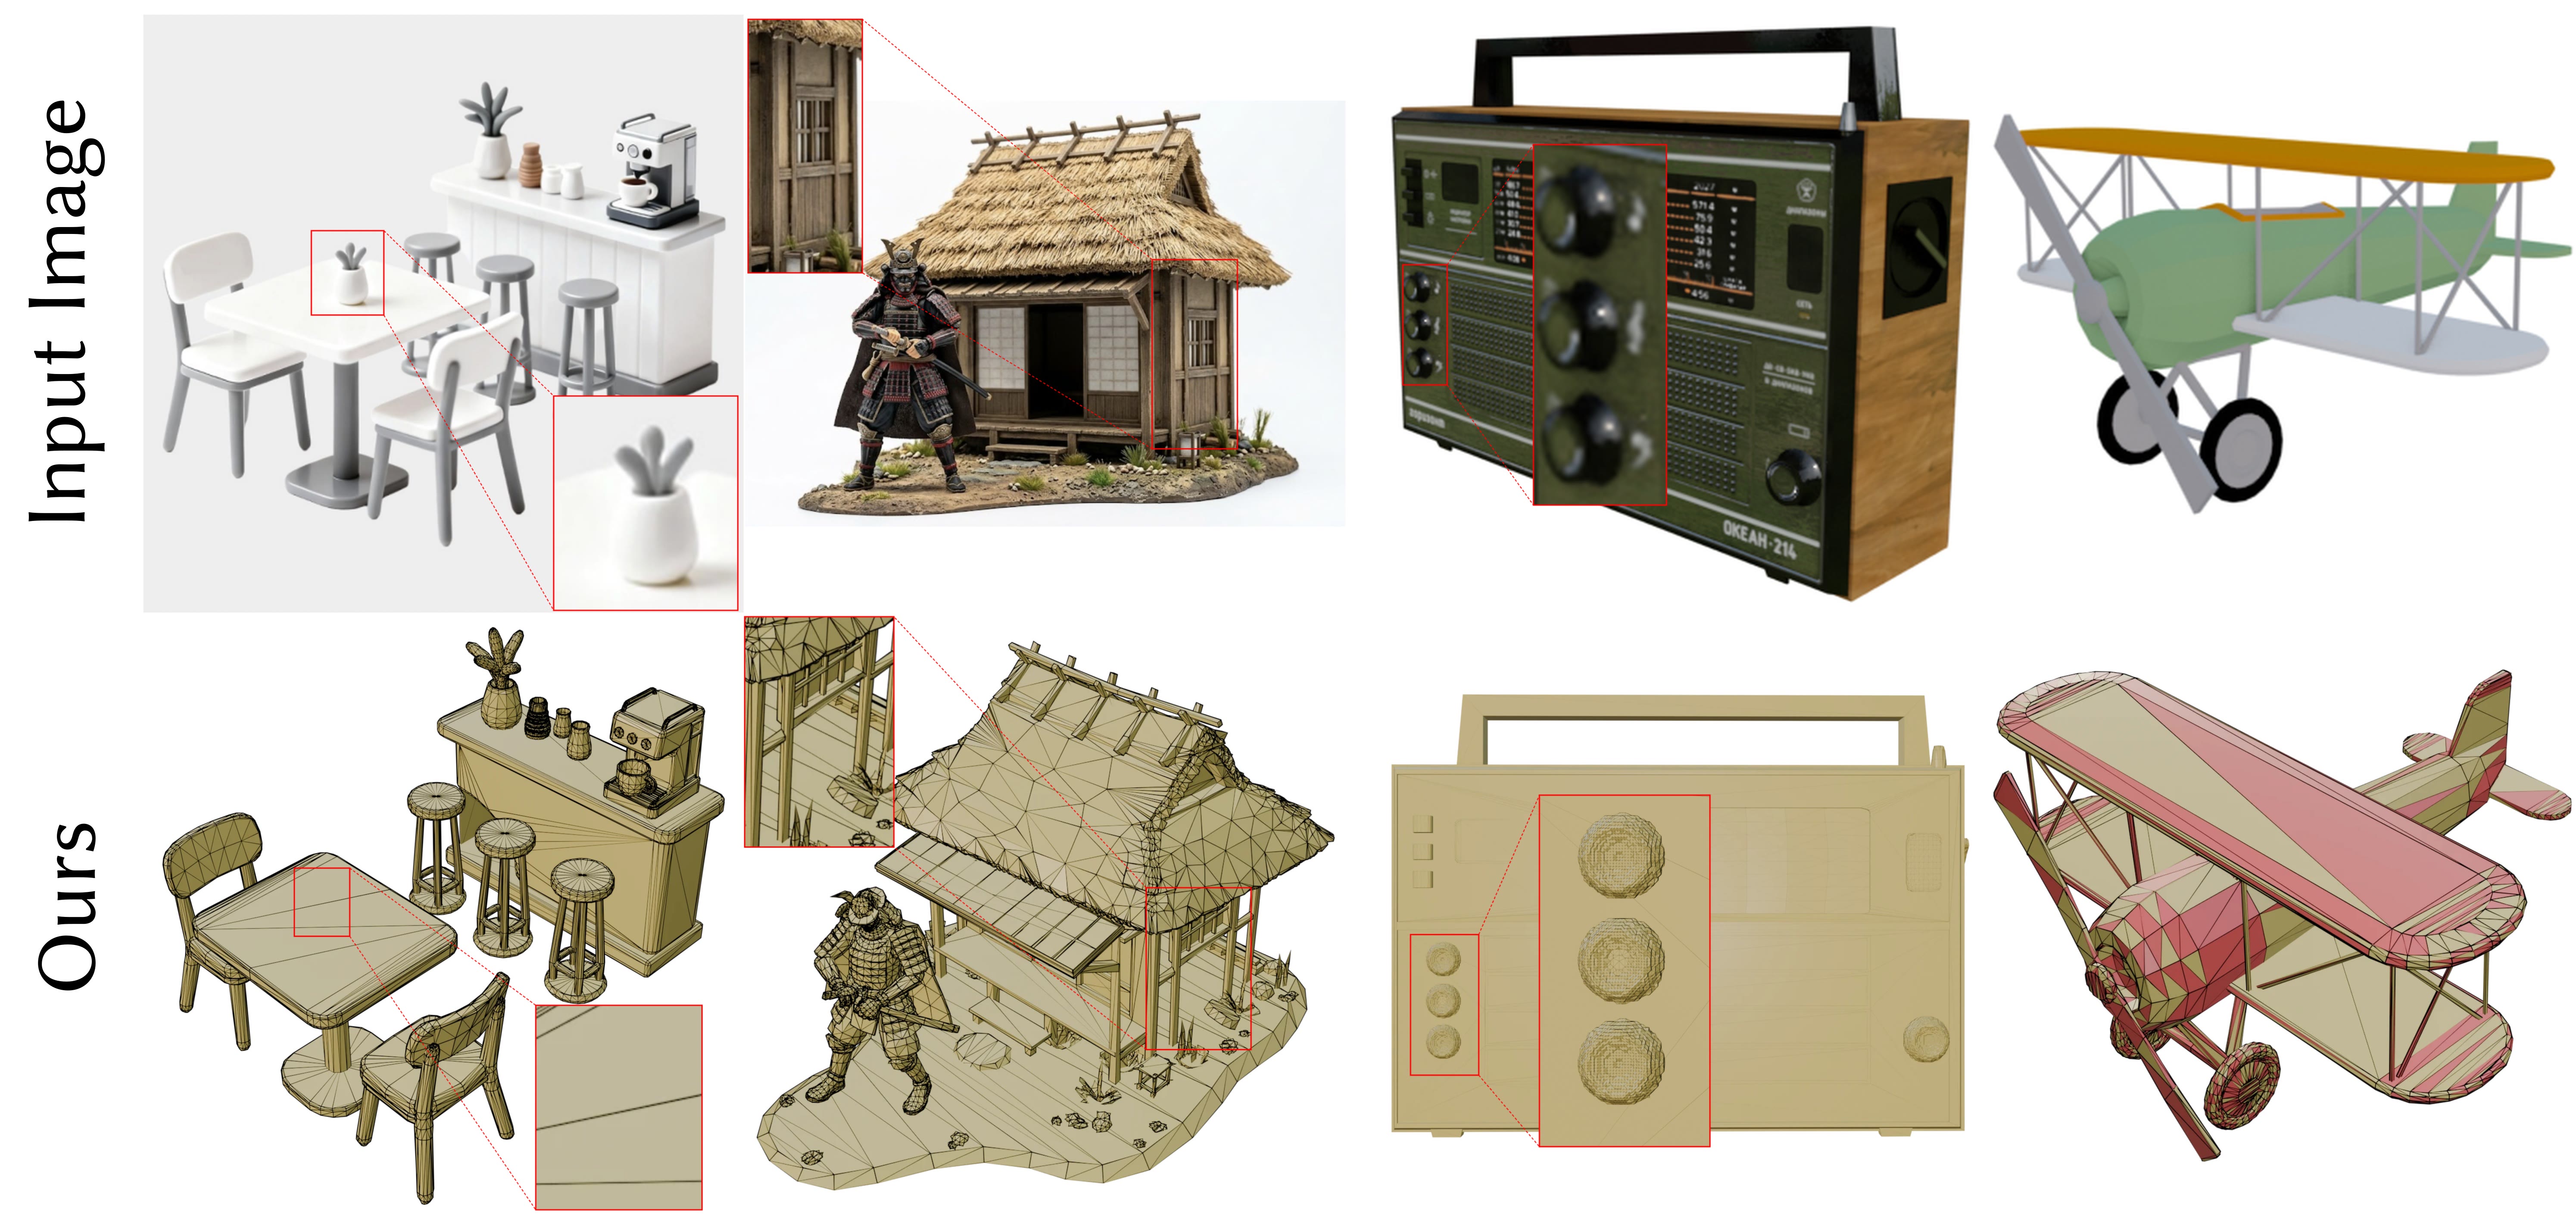
图来自原论文Fig. 12,依次展示小部件遗漏、缺面、量化造成的结构失真和面朝向不一致。
首先,不用自回归,并不意味着生成就足够快。八叉树仍然是一层一层地生成,每层都要进行diffusion采样。作者在局限性中强调了这个阶段的推理开销,并提出可以考虑few-step training或蒸馏来加速。
其次,坐标被量化到固定深度的八叉树中,细小结构仍然会受到分辨率限制;图像中的纹理和几何也可能被混淆,生成结果依然可能遗漏部件或出现缺面。至于法向,前面已经提到,拓扑连接正确与面的朝向一致是两件事,模型还需要额外的orientation correction。
此外,虽然它避开了逐token生成的累计误差,但两阶段之间仍然存在依赖:顶点阶段如果遗漏了一部分结构,后面的拓扑阶段只能在已有的顶点上建立连接,很难凭空补回缺失的几何。
总结
Nexus的主要思路可以归纳为三步:
- 用八叉树diffusion生成顶点
- 用topology diffusion生成逐顶点latent
- 用Spacetime Interval恢复边和面
其核心是把离散的拓扑关系转成一种能够被连续生成模型学习的表示。
从这篇文章出发,可以继续探索这样的拓扑表征方式是否在更多的场景和任务下有明显作用;另外其生成速度、坐标精度和面朝向等问题,也需要继续改进。读完之后,SpaceMesh也很值得回头看一下,尤其是它如何提出和使用Spacetime Distance;这样应该能更清楚地理解Nexus究竟在它的基础上往前走了哪一步。
参考
- 原文:arxiv 2607.13563
- AI协助润色